MACHINE LEARNING FOR BUSINESS / BANA409
机器学习商业应用:期末复习笔记.
BANA409 / ML4Biz 期末复习:从 Python 与数据处理,到决策树、模型评估、线性回归、梯度下降与集成学习。汇集 12 章笔记、84 道综合自测及答案、A4 手写提纲与勘误来源。
BANA409 期末复习导航
版本:v1.2,2026-10-21(初版 2026-10-19)· 按课程顺序编排 · 正文中文,术语中文(English),代码语法保持原样,注释简洁中文。
这套资料用于先建立知识框架,再练习纸笔作答,最后筛选本人手写的 A4 双面速查表(cheat sheet)。公式、代码输出和判断题都应能脱离电脑解释。
本次修订补充了“场景 → 数据含义 → 代码 → 输出 → 结果用途”的说明,重点包括 NumPy 索引/聚合/广播、Pandas 筛选/分组,以及预处理和模型流水线。建议读代码时先说清一行或一个轴代表什么,再看输出形状和数字;前文已有的数据会明确续用,新增模拟例子会说明其用途。
本次网页修订补齐示例的控制台输出、表格与实际绘图。代码块后的“运行输出”来自对应教学代码;只赋值而不显示的示例增加了必要的 print。模型输出用于理解模拟数据,不代表真实业务表现;不同库版本可能存在末位数值差异。综合自测题仍保留独立作答与答案对照。
1. 考试信息与范围
依据官方期末考试要求:
- 时间:2026 年 10 月 26 日,10:00–11:15,共 75 分钟。
- 地点:经世楼;MIS 班 E202,FIN 班 E203。
- 形式:纸笔、闭卷;题型为判断题、选择题、简答题。
- 可带一张 A4 纸,双面,必须本人手写;打印、打字、复印版本不允许使用。
- 本资料和自编题不是老师发布的题库;复习侧重与模拟卷分值均为学习建议,不代表官方命题权重。
2. 按课程顺序的知识框架
| 顺序与笔记 | 要回答的核心问题 | 应掌握的纸笔能力 |
|---|---|---|
| 01 AI 与机器学习概览 | 商业问题如何变成预测任务? | 区分特征/目标、分类/回归、训练/验证/测试;解释业务价值 |
| 02 Python 基础 | 如何表达数据、条件、循环和函数? | 读输出,判断切片边界、可变性、返回值 |
| 03 NumPy | 多维数组如何计算? | 写出 shape;解释 axis、广播、矩阵乘法 |
| 04 Pandas | 如何筛选、分组、汇总表格? | 区分 loc/iloc,写布尔条件,选正确统计分母 |
| 05 Matplotlib | 应选择哪种图说明问题? | 区分 Figure/Axes,解释箱线图、直方图、散点图 |
| 06 基线与 Kaggle | 复杂模型究竟比什么好? | 构造规则基线,区分竞赛测试文件与本地留出集 |
| 07 数据预处理 | 如何处理缺失、异常、类别和尺度? | 计算标准分数,解释编码、训练统计量与数据泄漏 |
| 08 决策树 | 如何选择分裂、限制复杂度? | 计算熵/Gini/信息增益,读树,解释剪枝参数 |
| 09 模型评估与完整流水线 | 如何可信地选择和解释模型? | 混淆矩阵、指标/成本、CV、网格搜索、Pipeline、特征重要性 |
| 10 线性回归 | 怎样预测数值并解释误差? | 读系数,计算 MSE/RMSE/MAE/R²,理解正规方程 |
| 11 梯度下降 | 怎样逐步学到参数? | 手算一次更新,比较 BGD/SGD/小批量,解释学习率 |
| 12 集成学习 | 多个模型为何可能优于单个模型? | 比较投票/装袋/提升、随机森林/OOB、AdaBoost/GB |
课程主线可以连成:商业问题 → 数据探索 → 规则基线 → 数据划分 → 预处理 → 训练 → 验证与调参 → 最终测试 → 解释与业务行动。第 2–5 章是工具,第 6–9 章建立完整流程,第 10–12 章扩展模型与训练方法。
3. 配套资料
| 文件 | 用法 |
|---|---|
| 13 综合自测 | 48 道判断、12 道选择、12 道简答、12 道代码/计算题;先遮住笔记作答 |
| 14 综合自测答案 | 检查结论、理由、条件与计算过程;为错题写一句纠正说明 |
| 15 A4 双面手写提纲 | 按正反面分区的候选内容;先试写一栏,再决定删减 |
| 16 勘误与来源 | 核对容易误记的课程表述、optional 边界、来源与术语 |
每章配有概念、公式或语法、示例、易错点与自测。代码块中以 df、X_train 等开头而未构造数据的片段,按其上下文读取;不要把不同章节片段无差别拼成一个程序。
4. 范围边界
官方明确排除的独立章节:多项式回归与正则化(Polynomial Regression and Regularization)、逻辑回归(Logistic Regression)、支持向量机(Support Vector Machine)、聚类(Clustering)、代码管理(Code Management)、数据应用(Data App)。不需要为这些章节准备单独的公式与 API 清单。
同一术语若出现在范围内章节,仍需理解其当时的用途。例如:概览中的无监督学习、树的复杂度约束、投票中使用不同模型,不能因为另一个独立章节被排除而全部跳过。
课程的 ROC/AUC、正规方程推导、OLS 与 R²等页面带有 optional 标记。optional 不等于考试页明确排除;先掌握正文,再学习这些标注拓展的细节。R²在作业 4 明确使用,本资料将基本公式与解释列为主线。作业 4 的 Data App 部分依然属于官方排除章节。
5. 三轮复习法
第一轮:理解结构
按 01→12 阅读。每章结束后,不看笔记回答:“输入是什么?输出是什么?核心规则是什么?什么条件下会失效?”此时只标记不熟的知识,不急着把整章抄到 A4 上。
第二轮:纸笔练习
做章末自测及综合题。公式题写符号含义、代入式和结果;代码题写对象类型、shape 或输出;判断题即使答对,也要能解释为什么。遇到错误时回到对应章节,而不是仅背正确选项。
第三轮:压缩与模拟
将经常混淆的公式、条件和短代码压缩到手写提纲。做一次 75 分钟限时练习,记录查表耗时,删去熟悉而占位置的内容,补入真实错点。
6. 考前七个复习单元
下表保留从 10/19 到考前一天的七单元安排,不假设每天固定时长。若现在才开始,可合并已过去日期的单元,按掌握情况缩短熟悉部分,仍保持课程顺序。
| 日期 | 内容 | 当天完成标准 |
|---|---|---|
| 10/19 | 01–03:概览、Python、NumPy | 解释工作流;独立读出切片、循环、shape 与广播结果 |
| 10/20 | 04–05:Pandas、Matplotlib | 能将业务问题写成筛选/分组步骤,并选对图型 |
| 10/21 | 06–08:基线、预处理、决策树 | 识别泄漏,算一次标准化和信息增益 |
| 10/22 | 09:评估与完整流水线 | 手算指标/成本/训练次数,画出 fit/transform 的数据流 |
| 10/23 | 10–11:线性回归与梯度下降 | 算误差与一次更新,区分模型、目标函数和优化器 |
| 10/24 | 12 与跨章题 | 比较三类集成;联系作业中的业务决策;列出错题 |
| 10/25 | 限时练习、手写 A4 | 完成一套模拟练习并订正;确认手写内容清晰可查 |
7. 一套 75 分钟自编模拟练习
从综合自测中抽取以下题目。此安排只用于练习节奏,官方未公布题量与分值。
| 部分 | 题号 | 时间 | 自评分值 |
|---|---|---|---|
| 判断 | T01、T05、T10、T15、T17、T24、T25、T30、T34、T40、T43、T47 | 8 分钟 | 12 × 1 = 12 |
| 选择 | M01–M12 | 12 分钟 | 12 × 2 = 24 |
| 简答 | S01、S09、S12 | 18 分钟 | 3 × 8 = 24 |
| 代码/计算 | P03、P08、P09、P11 | 30 分钟 | 4 × 10 = 40 |
| 检查 | 分母、正类、轴、单位与公式符号 | 7 分钟 | — |
简答评分可按“结论正确、理由完整、适用条件、具体例子”四项各 2 分;综合题按步骤分配分值,不只看最终数字。
8. 最后检查清单
- 能按课程顺序概括 12 个主题。
- 能区分训练、验证、测试与 Kaggle 的无标签测试文件。
- 能手算 shape、标准化、树不纯度、分类指标、回归误差、一次 GD 更新。
- 能解释数据泄漏、过拟合、重要性与因果之间的边界。
- 能比较规则、树、线性回归、SGD 训练、随机森林与提升方法。
- A4 已本人手写,双面内容可读;不是打印本资料。
来源快照读取于 2026-10-19。考试通知如有更新,以课程考试页为准。
01|人工智能与机器学习概览(Introduction to AI and ML)
本章目标:能把商业问题翻译成预测任务,解释完整工作流程,并区分特征、目标与数据集的用途。按照课程期末范围,学习类型的概念属于本章;聚类算法的具体推导不在本次范围内。
1. 从商业目标出发
人工智能(Artificial Intelligence, AI)是广义领域;机器学习(Machine Learning, ML)关注从数据中学习模式。模型(Model)描述输入与输出之间的关系;业务价值取决于预测之后采取的行动。
| 商业问题 | 可定义的预测任务 | 输出 | 可能行动 |
|---|---|---|---|
| 哪些付费客户可能流失? | 客户流失预测(Customer Churn Prediction) | 流失/不流失,或流失概率 | 向适合挽留的客户提供优惠 |
| 哪个广告更容易被点击? | 点击预测(Click Prediction) | 点击/不点击,或点击概率 | 调整广告设计与投放 |
| 下月收入大约多少? | 收入预测(Revenue Prediction) | 连续数值 | 制定预算与排班 |
点击率(Click-Through Rate, CTR)的描述性定义:
“预测单次展示是否点击”是分类;“预测未来一天的 CTR 数值”可设为回归。任务类型由目标变量及其含义决定,不能只看业务名称。
模型准确不自动等于商业成功:错误的成本、干预费用、可操作性和部署后的数据变化都影响最终收益。
2. 读懂一张数据表
假设每行记录一位客户:
| customer_id | age | payment_method | days_since_purchase | churn |
|---|---|---|---|---|
| A01 | 28 | card | 12 | 0 |
| A02 | 55 | cash | 90 | 1 |
- 样本/实例(Sample / Instance):一行观察记录。必须先明确“一行代表什么”,才能计算比例和解释模型。
- 特征/属性(Feature / Attribute):用于预测的输入,例如年龄、付款方式、距上次购买的天数。
- 目标/标签(Target / Label):希望预测的输出,例如
churn。 - 标识符(Identifier):识别记录的字段。
customer_id通常不能直接解释为有意义的数值大小。
常用记号: 为特征矩阵, 为目标向量;有 个样本、 个特征时, 的形状为 , 通常为 。
| 数据类型 | 含义 | 例子 | 判断注意 |
|---|---|---|---|
| 连续数值(Continuous Numerical) | 可在区间内取值 | 收入、身高 | 文件存成整数不一定意味着概念上离散 |
| 离散数值(Discrete Numerical) | 可计数的数值 | 购买次数、投诉次数 | 能进行有意义的数量运算 |
| 名义类别(Nominal Categorical) | 类别无自然顺序 | 城市、付款方式 | 数字编码不赋予大小意义 |
| 有序类别(Ordinal Categorical) | 类别有自然顺序 | 低/中/高 | 相邻等级的差距未必相等 |
0/1 可以编码类别;邮政编码看似数字,却通常是类别或标识。存储类型(Dtype)与统计含义不是同一件事。
3. 三种学习方式
| 学习方式 | 训练时有什么信息 | 主要目标 | 本课程例子 |
|---|---|---|---|
| 监督学习(Supervised Learning) | 特征 与已知标签 | 学习从输入到输出的关系 | 决策树分类、线性回归 |
| 无监督学习(Unsupervised Learning) | 输入数据,没有给定预测标签 | 发现结构或关联 | 客户聚类、关联规则 |
| 强化学习(Reinforcement Learning) | 行动及反馈奖励 | 学习提高长期奖励的策略 | 多臂老虎机、Q-learning 的概念 |
监督学习再区分:
- 分类(Classification):预测有限类别,如流失/不流失、评级 A/B/C。
- 回归(Regression):预测数值,如价格、需求量。目标是计数也可能作为回归问题,关键是任务设定。
“分类”与“聚类(Clustering)”不同:分类利用已知标签学习;聚类寻找未预先标注的群组。
4. 课程中的完整工作流程
| 顺序 | 阶段 | 必须回答的问题 | 常见产出 |
|---|---|---|---|
| 1 | 确定商业目标与价值 | 预测能帮助谁做什么决定? | 业务目标、成功标准 |
| 2 | 探索性数据分析(Exploratory Data Analysis, EDA) | 数据是什么样,是否存在异常模式? | 类型、描述统计、可视化 |
| 3 | 数据清洗(Data Cleaning) | 缺失、错误、异常如何处理? | 清洗规则与处理后的数据 |
| 4 | 特征工程(Feature Engineering) | 哪些输入能表达问题? | 转换、创建与选择特征 |
| 5 | 训练与评估 | 模型能否推广到未见数据? | 验证结果、选定模型 |
| 6 | 上线、监控与更新 | 实际表现是否下降? | 持续监测、补充数据、重新训练 |
这是一种概念顺序,实际工作会反复迭代。实施建模时,应在会学习数据统计量的步骤之前划分数据;填补均值、缩放参数等由训练数据学习,避免把验证集或测试集信息带入训练。
“垃圾进,垃圾出”(Garbage In, Garbage Out, GIGO)强调数据质量会限制结果。异常值(Outlier)可能是错误,也可能是真实的重要客户;不能看到极端值就自动删除。
特征工程的三个层次:
- 特征转换(Feature Transformation):分箱、对数变换、缩放、类别编码。
- 特征提取/创建(Feature Extraction / Creation):从原始信息构造有用表示,如距上次购买的天数。
- 特征选择(Feature Selection):选择与任务相关的输入。相关性或重要性分析只能提供证据,不能直接证明因果关系。
5. 训练、验证、测试各做什么
| 数据集 | 用途 | 会不会影响模型选择? |
|---|---|---|
| 训练集(Training Set) | 学习参数,如回归系数、树的划分规则 | 会 |
| 验证集(Validation Set) | 比较算法、调整超参数、选择方案 | 会 |
| 测试集(Test Set) | 对最终方案进行独立评估 | 应在选择完成后使用 |
泛化(Generalization)指模型对未见数据的适用能力。过拟合(Overfitting)常表现为训练集很好、未见数据明显变差;欠拟合(Underfitting)常表现为训练和验证都较差。
参数(Parameter)由训练算法学习;超参数(Hyperparameter)通常由建模者设置并通过验证选择,例如树的 max_depth。
部署(Deployment)后仍需监控:客户行为、业务流程、数据分布可能变化;原来的好模型不保证永久有效。
6. 最小代码:识别输入与目标
import pandas as pd

df = pd.DataFrame({
    "age": [28, 55, 40],
    "days_since_purchase": [12, 90, 30],
    "churn": [0, 1, 0],
})

X = df[["age", "days_since_purchase"]]  # 输入特征
y = df["churn"]                       # 预测目标
print(X.shape, y.shape)                 # (3, 2) (3,)
不需要在本章背完整训练代码,先能解释每一列为何出现在 或 中。若把 churn 同时放入 ,模型等于提前看到了答案,会造成目标泄漏(Target Leakage)。
怎样读上面的输入与输出? 假设我们在月末预测下月流失,每行是一位客户在该月末的状态;age 是年龄(年),days_since_purchase 是距上次购买的天数,历史标签 churn=1 表示其随后一个月实际流失。X 的两列是预测时已知的信息,y 的三个数分别对应同样三行客户。
训练结束后,面对一位尚不知道下月结果的新客户,只能提供同样定义的两列:
new_customer = pd.DataFrame({
    "age": [35], "days_since_purchase": [60],
})
print(new_customer.shape)  # (1, 2):一个客户、两个特征
这只是准备预测输入,还没运行模型。之后 model.predict(new_customer) 才会返回一个类别;真实下月结果到来后,才能与它比较。若额外放入“下月是否流失”或“下月购买次数”,实际预测时拿不到这些列,训练流程便失去了使用价值。
7. 纸笔例题与解答
题目。 某企业有 1,000 位客户,其中 200 位在下月流失。数据中有年龄、历史消费次数、下月是否流失。企业希望提前安排挽留活动。
- 一行、特征、目标各是什么?属于哪类学习?
- “全部预测不流失”的准确率是多少?是否足够证明方案有价值?
- 能否将“下月实际投诉次数”用于月初预测?
解答。
- 一行为一位客户;年龄、历史消费次数为候选特征;下月流失为目标。存在已知标签,属于监督分类。
- 准确率为 ,但一个流失客户也没有找出。必须结合漏掉流失客户的损失、挽留成本和业务目标评价。
- 月初尚不知道这一信息,直接使用会引入未来信息泄漏。特征必须在实际预测时可获得。
8. 易错点
- 模型预测“概率”仍然可以属于分类;分类并非只能直接输出 0/1。
- 数字标签不一定是回归目标,类别编码也不会自动拥有距离含义。
- 测试集反复用于挑选方案后,就不再是独立的最终检验。
- 模型发现关联不等于证明因果,尤其不能直接推出某种干预必然有效。
- EDA、清洗、训练、部署不是一次完成后永不回头的流水线。
9. 自测
- 预测房价与预测房屋是否售出,分别是什么任务?
- 客户年龄和客户编号都存为整数,能否同样解释其大小?
- 调整树深度应主要依据哪个数据集的表现?
- 为什么一个 95% 准确率的模型仍可能没有商业价值?
- 上线模型后为什么还要收集新数据?
简答: 1. 回归、分类。2. 不能,编号通常仅用于识别。3. 验证集或交叉验证。4. 可能只是多数类基线,或错误/行动成本抵消收益。5. 检查分布与业务变化,并支持模型更新。
课程来源
本章纸笔例题为复习自编,不是教师公布的试题。
02|Python 基础(Python Basics)
本章目标:看懂短代码、逐行追踪变量和输出,解释容器与控制流程。课程链接的 Python Cheatsheet 是参考大全,本章围绕课堂列出的基础主题整理。
1. 类型、运算与字符串
| 内容 | 语法/例子 | 结果或含义 |
|---|---|---|
| 整数、浮点、字符串、布尔 | int, float, str, bool | 3、3.0、"3"、True 类型不同 |
| 普通除法 | 7 / 2 | 3.5 |
| 向下取整除法 | 7 // 2;-7 // 2 | 3;-4,向负无穷取整 |
| 取余(Modulo) | 7 % 2 | 1 |
| 幂(Exponentiation) | 2 ** 3 | 8,不是 2 ^ 3 |
| 比较 | == != < <= > >= | 返回布尔值;= 是赋值 |
| 逻辑 | and, or, not | 组合或取反条件 |
| 类型转换 | int("3"), float("3.5"), str(3) | 无法转换时会报错 |
| 长度与类型 | len(x), type(x) | 字符串/容器长度;对象类型 |
先括号,再幂,再乘除与取余,再加减;不确定时使用括号。-2 ** 2 是 -(2 ** 2)=-4,(-2) ** 2=4。
price = 12.5
quantity = 3
revenue = price * quantity
print(f"Revenue = {revenue:.2f}")  # Revenue = 37.50
text = "machine learning"
print(text.upper())               # 大写,不修改原字符串
运行输出:
Revenue = 37.50
MACHINE LEARNING
格式化字符串(f-string)用 {表达式} 插值,.2f 表示保留两位小数。input() 的返回值为字符串,数值计算前需要适当转换。int(3.9) 得到 3,不是四舍五入。
2. 四类容器
| 类型 | 创建 | 有顺序 | 可变(Mutable) | 重复值 |
|---|---|---|---|---|
| 列表(List) | [1, 2, 2] | 有,可按位置索引 | 是 | 允许 |
| 元组(Tuple) | (1, 2, 2);单元素 (1,) | 有,可按位置索引 | 元组元素位置不可重新赋值 | 允许 |
| 字典(Dictionary) | {"a": 1, "b": 2} | 保留插入顺序 | 是 | 键唯一,值可重复 |
| 集合(Set) | {1, 2};空集合 set() | 无位置顺序保证 | 是 | 元素唯一 |
Python 3.7 起,字典保留插入顺序;读取 d[1] 仍表示键为 1,不是“第 2 个元素”。集合 set 可增删,不能按位置索引;不可变集合另有 frozenset,不必与基础 set 混淆。空的 {} 是字典。
可变性说的是对象本身能否改变,而非变量能否重新绑定。元组中若含列表,那个列表仍可变;基础题通常只使用简单元素。
items = [10, 20, 30]
items.append(40)                 # 加入一个元素
items.extend([50, 60])           # 逐个加入多个元素
last = items.pop()               # 删除并返回末尾元素
prices = {"tea": 5, "coffee": 8}
prices["tea"] = 6               # 更新已有键
prices.get("juice", 0)          # 缺失键返回默认值
unique_items = set([1, 1, 2])    # {1, 2}

# 显示本例需要观察的结果
print("items:", items, "last:", last)
print("prices:", prices, "unique_items:", unique_items)
运行输出:
items: [10, 20, 30, 40, 50] last: 60
prices: {'tea': 6, 'coffee': 8} unique_items: {1, 2}
append([3,4]) 加入一个嵌套列表;extend([3,4]) 加入两个元素。x.sort() 原地排序,返回 None;sorted(x) 返回新的排序列表。
3. 索引与切片
索引(Indexing)从 0 开始,负数从末尾计数。切片(Slicing)的形式为 x[start:stop:step],包含起点、不包含终点。
x = [10, 20, 30, 40, 50]
print(x[0], x[-1])     # 10 50
print(x[1:4])          # [20, 30, 40]
print(x[::2])          # [10, 30, 50]
print(x[::-1])         # [50, 40, 30, 20, 10]
运行输出:
10 50
[20, 30, 40]
[10, 30, 50]
[50, 40, 30, 20, 10]
列表的 + 是连接,* 是重复:[1,2]+[3,4] → [1,2,3,4];[1,2]*2 → [1,2,1,2]。这与 NumPy 的逐元素运算不同。
a = [1, 2, 3]
b = a               # 同一个列表
c = a[:]            # 浅复制
b[0] = 9
print(a, c)         # [9, 2, 3] [1, 2, 3]
运行输出:
[9, 2, 3] [1, 2, 3]
浅复制(Shallow Copy)复制外层容器;若内部含可变对象,内部对象可能仍共享。本课基本一维数值例子中,修改切片元素不会改变原列表。
4. 条件与循环
score = 75
if score >= 90:
    grade = "A"
elif score >= 60:
    grade = "Pass"
else:
    grade = "Fail"

# 显示本例需要观察的结果
print(grade)
运行输出:
Pass
if/elif/else 链只执行第一个成立的分支。缩进决定语句归属。0、None、空字符串及空容器通常为假;非空字符串 "False" 为真。
| 语法 | 含义 |
|---|---|
range(5) | 0,1,2,3,4 |
range(1,6,2) | 1,3,5 |
for x in values: | 依次遍历元素 |
while condition: | 条件成立就继续,需要保证条件最终可变化 |
break | 退出当前最内层循环 |
continue | 跳过本轮剩余语句,开始下一轮 |
pass | 什么也不做,仅作为占位语句 |
names = ["Amy", "Bo"]
scores = [80, 90]
for i, name in enumerate(names):
    print(i, name)                   # 索引与值
for name, score in zip(names, scores):
    print(name, score)               # 对应元素配对
for key, value in {"a": 1, "b": 2}.items():
    print(key, value)                # 字典键值对
运行输出:
0 Amy
1 Bo
Amy 80
Bo 90
a 1
b 2
zip() 默认在最短输入耗尽时结束。直接 for key in d 遍历字典的键;.values() 遍历值,.items() 遍历键值对。
5. 推导式、函数与导入
推导式(Comprehension)把简单循环表达为一个构造容器的表达式:
squares = [x ** 2 for x in range(5) if x % 2 == 0]  # [0, 4, 16]
mapping = {x: x ** 2 for x in range(3)}             # {0: 0, 1: 1, 2: 4}
remainders = {x % 2 for x in range(5)}              # {0, 1}
labels = ["high" if x >= 3 else "low" for x in range(5)]

# 显示本例需要观察的结果
print(labels)
运行输出:
['low', 'low', 'low', 'high', 'high']
末尾 if 表示筛选哪些元素进入结果;前面的 a if 条件 else b 表示每个元素取什么值。
def revenue(price, quantity=1):
    total = price * quantity       # 局部变量
    return total

answer = revenue(8, quantity=3)     # 24
print(answer)

import math
print(math.sqrt(9))                # 3.0
运行输出:
24
3.0
函数(Function)通过参数(Argument / Parameter)接收输入,通过 return 交回结果;没有执行 return 值 时返回 None。print() 显示内容,不能替代 return。函数内创建的普通局部变量(Local Variable)只在局部作用域可用。
包/模块(Package / Module)通过 import 引入;import numpy as np 是为模块取别名,不改变其功能。避免把变量命名为 list、sum 等内置名称,以免遮蔽原功能。
把函数与推导式用于一个订单问题
需求:计算两笔订单各自的金额,再求合计。 每个元组表示 (单价, 数量),单位分别是元/件和件;沿用上面的 revenue(price, quantity) 函数。
orders = [(8, 3), (5, 1)]
amounts = [revenue(price, qty) for price, qty in orders]
print(amounts)       # [24, 5],一笔订单对应一个金额
print(sum(amounts))  # 29,两笔订单合计
运行输出:
[24, 5]
29
把推导式拆开读:for price, qty in orders 逐笔拆出两个输入;revenue(price, qty) 计算该笔金额;最外层 [...] 收集返回值。函数若只 print(total) 而不 return total,屏幕仍会显示金额,但 amounts 会收集到 [None, None],无法用于后面的求和。这就是“显示结果”和“把结果交给下一步计算”的区别。
6. Notebook 中的文字与公式
代码单元(Code Cell)运行 Python;Markdown 单元记录解释。常用 Markdown:# 标题、**粗体**、- 列表、[文字](网址)。LaTeX 行内公式用 $...$,独立公式用 $$...$$。这些是写作和解释工具,不会自动执行 Python。
7. 纸笔例题与解答
题目:写出最后的 total 与 out。
total = 0
out = []
for n in range(1, 7):
    if n == 5:
        break
    if n % 2 == 0:
        continue
    total += n
    out.append(n ** 2)
解答: n=1 时累加 1、加入 1;n=2 跳过;n=3 累加 3、加入 9;n=4 跳过;n=5 退出,因此 total=4,out=[1,9]。虽然 range 包含 6,循环没有执行到 6。
8. 易错点与自测
常见错误:把 = 当比较;忘记切片/range 的终点不包含;把 pass 当成跳过本轮;把 print 当返回值;把列表连接当数值相加;把字典插入顺序当位置索引。
len({1,1,2})是多少?type({})是什么?a=[3,1,2]; b=a.sort()后,a和b是什么?[x+1 for x in range(4) if x>1]是什么?- 函数只执行
print(3),把调用结果赋给x,x是什么? list(range(5,0,-2))是什么?
简答: 1. 2,dict。2. [1,2,3] 与 None。3. [3,4]。4. None。5. [5,3,1]。
课程来源
- Python Basics
- Python 课堂小组练习
- 教师 Python Cheatsheet
- Python 官方:数据结构(核对字典顺序与集合可变性)
纸笔例题与自测为复习自编。
03|NumPy:数组、轴与广播
本章目标:先判断形状(Shape),再判断数值;能把每个轴(Axis)和聚合结果翻译成业务含义。课程咖啡店练习使用 sales.shape == (3,4,5),依次代表门店、周、产品。
1. 数组结构与创建
多维数组(N-dimensional Array, ndarray)使用统一的数据类型描述元素,支持向量化(Vectorization)运算。数值分析中通常使用数值 dtype,不要把 Python 列表与数组的运算规则混为一谈。
| 属性/操作 | 含义 | a.shape == (2,3,4) 时 |
|---|---|---|
a.ndim | 轴的个数 | 3 |
a.shape | 每个轴的长度 | (2,3,4) |
a.size | 元素总数 | 2*3*4=24 |
a.dtype | 元素的数据类型 | 如 int64、float64 |
a.reshape(6,4) | 在元素数不变时改变形状 | 仍为 24 个元素 |
import numpy as np

a = np.array([[1, 2, 3], [4, 5, 6]])
print(a.shape, a.ndim, a.size)    # (2, 3) 2 6
zeros = np.zeros((2, 3))         # 全零数组
ones = np.ones((2, 3))           # 全一数组
steps = np.arange(1, 6, 2)       # [1, 3, 5],不含终点
points = np.linspace(0, 1, 3)    # [0., 0.5, 1.],默认含终点
flat = a.reshape(-1)            # 自动推算唯一未知维度

# 显示本例需要观察的结果
print("zeros:\n", zeros)
print("ones:\n", ones)
print("steps:", steps, "points:", points, "flat:", flat)
运行输出:
(2, 3) 2 6
zeros:
 [[0. 0. 0.]
 [0. 0. 0.]]
ones:
 [[1. 1. 1.]
 [1. 1. 1.]]
steps: [1 3 5] points: [0.  0.5 1. ] flat: [1 2 3 4 5 6]
文件中的数值可用 np.loadtxt("numbers.txt", delimiter=",") 读取,再按已知结构 reshape。不能把 24 个元素直接重塑成 (5,5)。
(5,) 是一维数组,既不是 (1,5) 行矩阵,也不是 (5,1) 列矩阵。a.T 交换二维数组的行列;一维数组转置后仍是一维,要得到列矩阵需 a.reshape(-1,1)。
2. 索引:一个整数会消去一个轴
2.1 先把三维数组理解成三张门店报表
你管理一家咖啡连锁店,记录了 3 家门店、4 周、5 种产品的销量。一个数字表示“某家店在某一周卖出某种产品的数量”,单位为件/杯,不是金额。下面沿用课程数据,后文的 sales、stores、products 均来自这里。
import numpy as np

np.random.seed(409)  # 复现课堂销量
sales = np.random.randint(20, 80, size=(3, 4, 5))
stores = ["Downtown", "Campus", "Airport"]
products = ["Latte", "Espresso", "Cold Brew", "Sandwich", "Cookie"]
| 轴 | 代表什么 | 索引与现实对象的对应关系 |
|---|---|---|
| 轴 0,长度 3 | 门店 | 0=市中心店 Downtown;1=校园店 Campus;2=机场店 Airport |
| 轴 1,长度 4 | 周 | 0=第 1 周,1=第 2 周,2=第 3 周,3=第 4 周 |
| 轴 2,长度 5 | 产品 | 0=拿铁,1=浓缩咖啡,2=冷萃,3=三明治,4=曲奇 |
可以把整个数组想成三张叠起来的表:先选哪家店的一张表,再选表中哪一周的行,最后选哪种产品的列。NumPy 只保存数字和位置;这些门店名、产品名是我们另行记录的对应关系。
数组用逗号区分不同轴,写作 sales[门店选择, 周选择, 产品选择]。: 表示该轴全部保留。整数固定一个位置,结果不再需要用那个轴区分不同对象;切片保留一段位置,也保留该轴。“消去轴”不是删除原数组的数据,而是返回结果少了一个维度。
2.2 从业务问题逐个翻译成索引
问题 A:校园店长要看自己店四周的完整报表。 门店固定为 1,周和产品全部保留:
campus = sales[1, :, :]  # 等价于 sales[1]
print(campus.shape)     # (4, 5):周 × 产品
print(campus)
运行输出:
(4, 5)
[[21 59 61 76 61]
 [30 36 58 38 66]
 [36 62 56 47 30]
 [50 28 59 47 64]]
输出如下,4 行分别是第 1–4 周,5 列仍按 products 排列:
[[21 59 61 76 61]
 [30 36 58 38 66]
 [36 62 56 47 30]
 [50 28 59 47 64]]
例如第一行第三个数 61 是校园店第 1 周的冷萃销量。此时只剩“周”和“产品”两个维度,不再需要门店轴。省略末尾的轴选择时,它们默认全部保留,因此 sales[1] 也得到同样的表。
问题 B:校园店的冷萃每周分别卖出多少杯? 固定门店 1、产品 2,只让周变化:
campus_cold_brew = sales[1, :, 2]
print(campus_cold_brew)        # [61 58 56 59]
print(campus_cold_brew.shape)  # (4,)
print(campus_cold_brew.sum())  # 234,全月冷萃销量
运行输出:
[61 58 56 59]
(4,)
234
1 选校园店,: 选四周,2 选冷萃。输出的四个数是四周的销量,可以接着画周趋势;若问题改成“全月共多少杯”,才再调用 .sum()。索引负责取出记录,求和负责汇总记录。
问题 C:机场店第 2–3 周,两种食品分别卖了多少? 1:3 取周索引 1、2,-2: 取末尾两种产品:
airport_food = sales[2, 1:3, -2:]
print(airport_food.shape)  # (2, 2):两周 × 两种食品
print(airport_food)
运行输出:
(2, 2)
[[52 47]
 [34 56]]
结果为 [[52,47],[34,56]]:第 1 行对应第 2 周,第 2 行对应第 3 周;第 1 列是 Sandwich,第 2 列是 Cookie。也就是第 2 周卖了 52 个三明治、47 块曲奇,第 3 周分别为 34、56。虽然两个轴长度都为 2,它们的含义完全不同;仅看 (2,2) 并不能知道行列代表什么。
问题 D:市中心店第 4 周卖了多少杯冷萃? 三个位置都固定,结果是一个数字:
units = sales[0, 3, 2]
print(units)  # 40 杯
运行输出:
40
2.3 对照速查:先说需求,再判断剩下哪些轴
| 选择 | 结果形状 | 业务含义 |
|---|---|---|
sales[1] | (4,5) | 校园店完整报表;行是周,列是产品 |
sales[:,1] | (3,5) | 三店第 2 周报表;行是门店,列是产品 |
sales[1,:,2] | (4,) | 校园店冷萃的四周销量 |
sales[:,1:2,:] | (3,1,5) | 第 2 周,保留周这个轴 |
sales[2,1:3,-2:] | (2,2) | 第 3 家门店,第 2–3 周,最后两种产品 |
sales[0,3,2] | 标量 | 第 1 家门店,第 4 周,第 3 种产品 |
2.4 为什么有时只取一周,也要保留周轴?
sales[:,1,:] 和 sales[:,1:2,:] 都取第 2 周的数据,但前者为 (3,5),后者为 (3,1,5)。后续函数若要求统一接收“门店 × 周 × 产品”,应使用后者。这样同一函数既可处理一周,也可处理多周。
one_week_table = sales[:, 1, :]     # 门店 × 产品
one_week_block = sales[:, 1:2, :]   # 门店 × 周 × 产品
print(one_week_table.shape)        # (3, 5)
print(one_week_block.shape)        # (3, 1, 5)
运行输出:
(3, 5)
(3, 1, 5)
切片包含起点、不包含终点;“第 2 周”对应索引 1,不是 2。对结果继续索引时,要按结果的新轴顺序理解:campus[0,2] 是校园店第 1 周的冷萃销量,已不再需要传入门店索引。
2.5 布尔索引:哪些周需要重点关注?
接问题 B,假设店长想找出“冷萃销量少于 60 杯的周”,用于进一步排查活动、客流或营业天数:
week_numbers = np.arange(1, 5)  # 现实周次 1–4
low = campus_cold_brew < 60
print(low)                    # [False True True True]
print(week_numbers[low])       # [2 3 4]:对应周次
print(campus_cold_brew[low])    # [58 56 59]:对应销量
运行输出:
[False  True  True  True]
[2 3 4]
[58 56 59]
布尔掩码(Boolean Mask)中的每个 True 保留相同位置的元素。只输出 [58,56,59] 会丢掉“是哪几周”的说明,因此同时筛选周次。阈值 60 是本例的业务筛选条件,不是统计异常值的通用界限。
3. 逐元素运算、复制与矩阵运算
a = np.array([1, 2, 3])
b = np.array([4, 5, 6])
print(a + b)         # [5, 7, 9]
print(a * b)         # [4, 10, 18]
print(a ** 2)        # [1, 4, 9]
print(a @ b)         # 32:1*4 + 2*5 + 3*6
运行输出:
[5 7 9]
[ 4 10 18]
[1 4 9]
32
逐元素(Element-wise)运算按位置进行;* 不是矩阵乘法,@ 才表示矩阵乘法/向量点积。二维矩阵 (m,k) @ (k,n) 得到 (m,n),中间维度必须相同。这也是后续线性回归矩阵公式的基础。
NumPy 的基本切片通常是视图(View),修改它会影响原数组;要独立数据应 .copy()。布尔索引、整数数组索引通常生成复制,不能把所有索引结果都当成视图。
a = np.array([1, 2, 3, 4])
b = a[1:3]             # 共享原数组数据
b[0] = 99
print(a)               # [1, 99, 3, 4]
c = a[1:3].copy()      # 独立复制
c[0] = 0
print(a)               # 仍为 [1, 99, 3, 4]
运行输出:
[ 1 99  3  4]
[ 1 99  3  4]
4. 聚合:axis 指定“被合并掉的维度”
聚合(Aggregation)包括 sum、mean、min、max、std 等。a.sum() 默认汇总所有元素,不指定 axis 并不等于默认按 axis=0 汇总。
对于二维数组:axis=0 合并各行,保留每列一个结果;axis=1 合并各列,保留每行一个结果。“沿哪个方向”容易记错,直接检查被删除的形状位置更稳妥。
a = np.array([[1, 2, 3], [4, 5, 6]])
print(a.sum())                    # 21
print(a.sum(axis=0))              # [5, 7, 9],形状 (3,)
print(a.sum(axis=1))              # [6, 15],形状 (2,)
print(a.mean(axis=0))             # [2.5, 3.5, 4.5]
print(a.sum(axis=1, keepdims=True))  # [[6], [15]],形状 (2, 1)
运行输出:
21
[5 7 9]
[ 6 15]
[2.5 3.5 4.5]
[[ 6]
 [15]]
三维咖啡店案例:
| 表达式 | 结果形状 | 一个结果元素表示什么 |
|---|---|---|
sales.sum(axis=0) | (4,5) | 某周某产品,所有门店合计 |
sales.sum(axis=1) | (3,5) | 某门店某产品,全月合计 |
sales.sum(axis=2) | (3,4) | 某门店某周,所有产品合计 |
sales.sum(axis=(1,2)) | (3,) | 每家门店全月总销量 |
sales.sum(axis=(0,1)) | (5,) | 每种产品全月总销量 |
sales.sum(axis=(0,2)) | (4,) | 每周所有门店、产品总销量 |
keepdims=True 将被汇总的轴保留为长度 1,常用于后续广播。np.median(a) 求中位数;np.std(a) 默认用总体标准差口径,即 ddof=0,与 Pandas .std() 默认口径不同。
把汇总结果读成一张新报表
需求:查看每家店全月各产品销量,比较产品构成。 每家店与每种产品仍要分别显示,只有“周”要合并,所以对原数组的轴 1 求和:
month_by_store_product = sales.sum(axis=1)
print(month_by_store_product.shape)  # (3, 5):门店 × 产品
print(month_by_store_product[1, 2])  # 234:校园店全月冷萃

store_total = month_by_store_product.sum(axis=1, keepdims=True)
product_share = month_by_store_product / store_total
print(store_total.shape)            # (3, 1):每店一个总销量
print(round(product_share[1, 2], 4)) # 0.2376:校园店冷萃占比
运行输出:
(3, 5)
234
(3, 1)
0.2376
第一步的 axis=1 是原数组的周轴;第二步的 axis=1 是新二维报表的产品轴。轴号取决于当前对象,不会永久绑定“周”。store_total 保留为 (3,1),能让每店的五种产品分别除以自己店的总量。例如校园店冷萃占比是 234/985,不是除以三店合计销量。
如果只关心“第 2 周三家店各卖了多少”,先筛出这一周,再把产品合计:
week2 = sales[:, 1, :]          # (3, 5):门店 × 产品
week2_units = week2.sum(axis=1) # 合计每家店的五种产品
print(week2_units)             # [215 228 243]
运行输出:
[215 228 243]
结果依次对应 Downtown、Campus、Airport。这里先索引再聚合;若先把四周全部相加,就不能再回答单独第 2 周的问题。
5. 最大值与最大值位置
max() 返回数值,argmax() 返回最大值的位置;argmin() 同理。默认 argmax() 将整个数组按顺序展开后返回位置,指定 axis 则返回该轴上的位置;并列时返回首先出现的位置。
a = np.array([[8, 2, 6], [3, 9, 1]])
print(a.max())              # 9
print(a.argmax())           # 4:展开后的索引
print(a.argmax(axis=0))     # [0, 1, 0]:每列最大值所在行
print(a.argmax(axis=1))     # [0, 1]:每行最大值所在列
运行输出:
9
4
[0 1 0]
[0 1]
需求:向老板报告“哪种产品销量最高、卖了多少”。 分成“汇总销量→找位置→取名字”三步,更容易检查:
product_units = sales.sum(axis=(0, 1))  # 各产品跨门店、周合计
best_index = product_units.argmax()
print(best_index)                      # 4,是位置,不是销量
print(products[best_index], product_units[best_index])  # Cookie 623
运行输出:
4
Cookie 623
压缩写法 products[sales.sum(axis=(0,1)).argmax()] 只返回名称。products 顺序必须与产品轴一致,否则数字算对也会贴错产品标签。
6. 广播(Broadcasting):从右向左比较
两数组逐元素运算时,从最右边的维度开始对齐。对应长度相等,或至少一个为 1,才可兼容;缺失的左侧维度视作 1。
sales: (3, 4, 5)
price:       (5,)  → (1, 1, 5) → 可广播,结果 (3, 4, 5)
cost:        (3,)  → (1, 1, 3) → 末轴 5 与 3 不兼容
cost.reshape(3,1,1)           → 每门店一个系数,兼容
数组广播不是“看到相同数字就自动找到对应轴”。price 对齐末轴产品维度;门店系数必须显式放在门店轴上。
np.random.seed(409)
sales = np.random.randint(20, 80, size=(3, 4, 5))
price = np.array([3.5, 3.0, 4.5, 6.5, 2.0])
cost = np.array([1.0, 1.2, 0.9])

revenue = sales * price                 # 数量 × 对应产品单价
store_units = sales.sum(axis=(1, 2))    # [934, 985, 1012]
store_revenue = revenue.sum(axis=(1, 2)) # [3628., 3881.5, 3902.5]
adjusted = sales * cost.reshape(3, 1, 1)

# 显示本例需要观察的结果
print("store_units:", store_units)
print("store_revenue:", store_revenue)
print("adjusted shape:", adjusted.shape)
运行输出:
store_units: [ 934  985 1012]
store_revenue: [3628.  3881.5 3902.5]
adjusted shape: (3, 4, 5)
把广播展开成一个具体位置的计算: revenue[0,3,2] = sales[0,3,2] * price[2] = 40 * 4.5 = 180,表示市中心店第 4 周冷萃收入 180 美元。五个单价沿产品轴对应,自动用于所有门店、所有周;不是把总收入乘五次。
若只做“校园店销量统一放大 20%”的情景演示,则 cost[1]=1.2 应作用于 sales[1,:,:] 里的每一个数。reshape(3,1,1) 中的 3 对准门店,两个 1 允许系数沿周与产品重复使用。例如校园店第 1 周冷萃为 61*1.2=73.2 个等效单位,这是调整后的情景量,不是实际发生了小数杯销量。
本例 cost 是课程给定的门店系数练习。adjusted 的业务含义由系数定义决定,不能仅凭变量名就称其为利润;利润还需要成本金额等信息。
销量最高不等于收入最高,收入最高也不等于利润最高。课堂数据中 Cookie 销量最高、Sandwich 收入最高,说明选择指标前必须明确问题。
7. 纸笔例题与解答
题目。 x=np.array([[2,4,6],[1,3,5]]),p=np.array([10,20,30])。求 (x*p).sum(axis=1),并写出中间和最终形状。
解答。 x 为 (2,3),p 的 (3,) 对齐最后一轴,乘积为 [[20,80,180],[10,60,150]],形状 (2,3)。沿 axis=1 合并产品轴,得到 [280,220],形状 (2,)。若行代表门店,这就是每店收入。
8. 易错点与自测
常见错误:把 size 当行数;把 (n,) 当列矩阵;把 axis=0 当“保留轴 0”;把最大值位置当最大值;基本切片修改后忘记原数组同步变化;广播时从左对齐。
(3,4,5)有几个轴、多少元素?sales[:,1:2,2]的形状是什么?sales.mean(axis=(0,2), keepdims=True)的形状是什么?(4,1)与(3,)相加结果形状是什么?- 要计算每周收入,怎样从
revenue汇总?
简答: 1. 3 个轴、60 个元素。2. (3,1)。3. (1,4,1)。4. (4,3)。5. revenue.sum(axis=(0,2)),形状 (4,)。
课程来源
咖啡店设置与核对值来自课堂练习;纸笔例题及末尾自测为复习自编。
04|Pandas:选择、汇总与业务口径
本章目标:能读懂索引、筛选与分组代码,并说明结果的统计单位和分母。Pandas 的标签(Label)会影响对齐和选择,不能一律按 NumPy 的位置运算理解。
1. Series 与 DataFrame
序列(Series)是一维带标签的数据;数据框(DataFrame)是二维表,可有多种列类型。
| 表达式 | 返回对象 | 典型形状 |
|---|---|---|
df["sales"] | Series | (n,) |
df[["sales"]] | DataFrame | (n,1) |
df[["branch","sales"]] | DataFrame | (n,2) |
df.loc[label,"sales"] | 通常是单个值 | 标签唯一时为标量 |
贯穿本章的自编小数据(每行是一笔交易,索引标签刻意不从 0 开始):
import pandas as pd

df = pd.DataFrame({
    "branch": ["A", "A", "B", "B"],
    "product": ["tea", "coffee", "tea", "coffee"],
    "quantity": [2, 1, 3, 2],
    "price": [5, 8, 5, 8],
}, index=[10, 20, 30, 40])
df["sales"] = df["quantity"] * df["price"]
这里一行是一笔只含一种产品的交易,quantity 为购买件数,price 为单价(元/件),sales 为交易金额(元)。建立派生列后,完整表为:
| 索引标签 | branch | product | quantity | price | sales |
|---|---|---|---|---|---|
| 10 | A | tea | 2 | 5 | 10 |
| 20 | A | coffee | 1 | 8 | 8 |
| 30 | B | tea | 3 | 5 | 15 |
| 40 | B | coffee | 2 | 8 | 16 |
后面的索引、筛选与分组都对这四笔交易操作。标签 20 表示第二条记录的标识,不是“第 20 行”。读取实际文件时用 pd.read_csv("filename.csv"),再确认一行到底代表交易、客户还是酒店。
2. 先检查结构,再计算
| 操作 | 能知道什么 |
|---|---|
df.head() / df.tail() | 开头/末尾记录 |
df.shape | 行数、列数 |
df.index / df.columns | 行标签、列标签 |
df.dtypes | 各列的存储类型 |
df.info() | 行列、非缺失数量、类型等;显示信息,返回 None |
df.describe() | 默认主要给出数值列的描述统计 |
df.describe(include="all") | 扩展到非数值列,有些统计量只适用于部分类型 |
df.isna().sum() | 各列缺失数量 |
describe() 常见数值统计:count、mean、std、min、25%、50%、75%、max。其中 count 是非缺失数;50% 为中位数,不一定等于均值。Pandas .std() 默认为样本标准差(ddof=1)。
“类别特征存为字符串”是完整描述;只说 object/string 描述了存储,没描述业务含义。
3. loc 与 iloc
| 方法 | 依据 | 切片终点 |
|---|---|---|
loc[行标签, 列标签] | 标签 | 通常包含终点标签 |
iloc[行位置, 列位置] | 从 0 开始的位置 | 不包含终点位置 |
print(df.loc[20, "sales"])              # 8,标签为 20 的行
print(df.iloc[1, 4])                     # 8,第 2 行第 5 列
print(df.loc[20:30, ["branch", "sales"]]) # 包含标签 20、30
print(df.iloc[1:3, [0, 4]])              # 包含位置 1、2
运行输出:
8
8
   branch  sales
20      A      8
30      B     15
   branch  sales
20      A      8
30      B     15
什么时候用哪一个? 已知交易标签 20,要查询其金额,用 df.loc[20,"sales"],得到 8 元;只想抽查当前表第二行,用 df.iloc[1]。排序后第二行可能换成另一笔交易,而交易标签 20 仍表示原来的那笔。df.iloc[1,4] 的列位置 4 对应 sales,因为新增后它是第 5 列。
df.loc[1] 查找标签 1,本例不存在,不能代替 df.iloc[1]。以上标签切片示例使用有序且唯一的索引;复杂重复或无序索引可能有额外限制。
避免含糊的链式赋值:需要修改选中行的某列时,使用一次 .loc[条件, 列名] = 值,例如 df.loc[df["branch"]=="A", "price"] = 6。
4. 条件筛选(Filtering)
mask = (df["branch"] == "B") & (df["quantity"] >= 2)
result = df.loc[mask, ["product", "sales"]]
tea_or_large = df[(df["product"] == "tea") | (df["sales"] >= 16)]
not_a = df[~(df["branch"] == "A")]
selected = df[df["product"].isin(["tea", "coffee"])]

# 显示本例需要观察的结果
print(result.to_string())
运行输出:
product  sales
30     tea     15
40  coffee     16
这段代码回答的问题是:B 店购买至少两件商品的交易,买了什么、花了多少? mask 依次为 [False,False,True,True];.loc 先选中标签 30、40,再只显示 product 和 sales 两列,结果是 tea/15 元与 coffee/16 元。这里仍是两条明细;再对结果的 sales 求和,得到这些符合条件交易的合计金额。本例 B 店两笔交易恰好都符合条件,所以也等于 B 店总收入;一般情况下不能把筛选后的收入当成全店收入。
逐元素逻辑使用 &、|、~,每个比较条件加括号;不能把整列用 Python 的 and/or 合并。mask 是一列布尔值,True 的行被保留。
5. 频数、去重与分母
| 写法 | 含义 |
|---|---|
df["branch"].value_counts() | 各分店出现的行数 |
df["branch"].value_counts(normalize=True) | 各分店占有效观测的比例 |
df["branch"].value_counts(dropna=False) | 把缺失也计为一类 |
df["branch"].nunique() | 不同非缺失值的数量 |
df["branch"].unique() | 不同值本身 |
df["sales"].count() | 金额非缺失的记录数 |
len(df) | 所有记录数 |
value_counts() 默认排除缺失值;normalize=True 默认分母也是非缺失观测数量。count() 与行数只在该列无缺失时相同。
课程作业中的关键口径: Marriott 数据仅包含 2020 年等级发生变化的酒店,而案例给出的全球酒店数为 7,737。因此:
若除以该数据集行数,得到的是“发生等级变化的酒店中升级的比例”,回答的是另一个问题。这里使用的是作业的历史案例数字,不代表当前酒店总数。
6. 分组聚合(GroupBy)
分组操作遵循“拆分—计算—组合”(Split–Apply–Combine)。先定义每组是谁,再明确每个输出统计量的单位。
totals = df.groupby("branch")["sales"].sum()   # A=18,B=31
means = df.groupby("branch")["sales"].mean()   # A=9,B=15.5
summary = df.groupby("branch").agg(
    total_sales=("sales", "sum"),
    avg_sales=("sales", "mean"),
    orders=("sales", "size"),
)
table = df.pivot_table(
    index="branch", columns="product", values="sales", aggfunc="sum"
)  # 行为门店,列为产品,值为销售额

# 显示本例需要观察的结果
print(summary.to_string())
print(table.to_string())
运行输出:
total_sales  avg_sales  orders
branch
A                18        9.0       2
B                31       15.5       2
product  coffee  tea
branch
A             8   10
B            16   15
同一份数据,三个不同问题: sum() 回答“每店总共收入多少”,A 为 10+8=18 元;mean() 回答“每笔交易平均多少钱”,A 为 18/2=9 元;size() 回答“有几笔交易”,A 为 2 笔。它们都按门店分组,但统计单位不同。
透视表 table 把门店放到行、产品放到列,得到:
| branch | coffee | tea |
|---|---|---|
| A | 8 | 10 |
| B | 16 | 15 |
这适合回答“B 店比 A 店多出的收入主要来自哪类产品”。注意列按结果中的名称读取,不能默认 coffee/tea 的顺序与原表首次出现顺序一致。
groupby(...).size() 计组内总行数;某列的 .count() 计其非缺失值数。pivot_table() 是作业中用于比较两个分类维度的工具;注意指定 aggfunc,其默认通常是均值。
df.groupby("branch").max() 会独立计算各列最大值,结果同一行内的不同字段未必来自同一笔交易。要找销售额最大的一整行,应先取得其索引:
best_rows = df.loc[df.groupby("branch")["sales"].idxmax()]

# 显示本例需要观察的结果
print(best_rows.to_string())
运行输出:
branch product  quantity  price  sales
10      A     tea         2      5     10
40      B  coffee         2      8     16
本例索引唯一且每组均有有效金额,得到 A 的 tea 交易和 B 的 coffee 交易。并列最大值时 idxmax() 取首次出现的位置;题目若要求所有并列记录,需要另外处理。
7. 派生列、排序、删除与输出
df["sales"] = df["quantity"] * df["price"]   # 向量化派生列
df["large"] = df["sales"] >= 15             # 布尔列
df["branch_lower"] = df["branch"].apply(str.lower)
ranked = df.sort_values("sales", ascending=False)
reset = ranked.reset_index(drop=True)          # 丢弃原索引标签
small = df.drop(columns=["large", "branch_lower"])
row_removed = df.drop(index=[20])              # 按标签删行
# small.to_csv("result.csv", index=False)      # 需要导出时执行

# 显示本例需要观察的结果
print(ranked[["branch", "sales"]].to_string())
print("reset index:", reset.index.tolist())
运行输出:
branch  sales
40      B     16
30      B     15
10      A     10
20      A      8
reset index: [0, 1, 2, 3]
sort_values()、drop() 等通常返回新对象,默认不原地改变 df;赋给变量,或明确使用支持的 inplace=True。不要写 df = df.sort_values(..., inplace=True),因为原地操作通常返回 None。
排序不会自动把标签改成 0,1,...;可用 ignore_index=True 或 reset_index(drop=True)。reset_index() 不带 drop=True 时通常将原索引保存为一列。
数值字符串的转换与合并属于常用辅助语法:pd.to_numeric(s, errors="coerce") 把无法解析的值转为缺失;s.astype(float) 要求值能被相应转换。pd.concat([a,b], axis=0) 按行拼接,axis=1 按列拼接并按行标签对齐。
8. 标签对齐(Alignment)
Pandas 的 Series 运算通常先按标签配对,而非按显示位置配对:
a = pd.Series([10, 20], index=["x", "y"])
b = pd.Series([1, 2], index=["y", "x"])
print(a + b)    # x=12,y=21
运行输出:
x    12
y    21
dtype: int64
例如把 a 看成两个门店原收入,b 看成补录收入:门店 x 的原收入 10 必须加上标签 x 的 2,得到 12;不能因为 1 显示在 b 的第一行,就把它加给 x。标签对齐解决的是“同一对象相加”,不是“显示在同一位置的数相加”。
给 DataFrame 赋一列 Series 也会按行标签对齐;缺少对应标签时可能产生缺失值。例如本章 df 的索引是 10,20,30,40,直接赋入默认索引 0,1,2,3 的 Series 就不会按行号自动匹配。若只想按位置赋值,必须先明确长度和顺序,再使用数组等无标签值。
9. 纸笔例题与解答
题目。 用本章交易表,计算 B 店销售额比 A 店高多少百分比;再求 B 店占全部销售额的比例。这两题分母分别是什么?
解答。 A 店 18,B 店 31。相对 A 的增幅为 ;B 的销售额占比为 。第一题分母是比较基准 A,第二题分母是总销售额。不能用 B/A 的 172.22% 直接声称“高 172.22%”。
10. 易错点与自测
常见错误:按位置理解 loc;筛选时遗漏括号;把 count 当所有行数;把逐列最大值当真实的一行;对无标签对应的 Series 赋值;只报告数字却不解释单位和分母。
- 本章
df.iloc[1:3]选中哪些行标签? df["sales"]与df[["sales"]]的维度有何不同?- 10 笔交易中金额缺失 2 笔,
len(df)与金额的.count()各是多少? groupby("branch")["sales"].mean()是每店总销售额吗?- 两个 Series 的标签相同但顺序相反,相加时按什么配对?
简答: 1. 20、30。2. 一维 Series、二维 DataFrame。3. 10 与 8。4. 不是,是每店每笔有效交易的平均金额。5. 按标签配对。
课程来源
四行交易表、纸笔例题与自测为复习自编;Marriott 分母来自课程作业案例。
05|Matplotlib:选图、读图与解释
本章目标:根据问题选图,能解释图中元素与分布,并读懂 Matplotlib 和 Pandas 绘图代码。复习时优先练习“这张图回答什么问题”,再记必要 API。
1. 图形对象、绘图区与坐标轴
| 名称 | 含义 | 对应代码 |
|---|---|---|
| 图形对象(Figure) | 最外层容器,包含一个或多个绘图区 | fig |
| 绘图区(Axes) | 一块具体绘图区域,内含曲线、坐标轴、标题等 | ax |
| 坐标轴(Axis) | 控制 x/y 等坐标维度的刻度与标签 | x-axis、y-axis |
| 标题(Title) | 说明图展示的问题或发现 | ax.set_title(...) |
| 轴标签(Axis Label) | 说明变量与单位 | ax.set_xlabel(...) |
| 刻度/刻度标签(Tick / Tick Label) | 具体坐标位置及其文字 | ax.set_xticks(...) |
| 图例(Legend) | 说明颜色、线条等编码含义 | ax.legend() |
| 标记(Marker) | 表示单个数据点的符号 | marker="o" |
注意:Axes 在这里是一个绘图区对象的名称,不是“多个 Figure”。一张 Figure 可以有多个 Axes,而每个 Axes 可以有 x 与 y 坐标轴。
2. 最小绘图模板
import matplotlib.pyplot as plt

weeks = [1, 2, 3, 4]
sales = [100, 120, 115, 140]
fig, ax = plt.subplots(figsize=(6, 4))
ax.plot(weeks, sales, marker="o", color="blue", label="Store A")
ax.set_title("Weekly sales increase from 100 to 140")
ax.set_xlabel("Week")
ax.set_ylabel("Sales (units)")
ax.set_xticks(weeks)
ax.legend()
fig.tight_layout()  # 减少标签遮挡
plt.show()
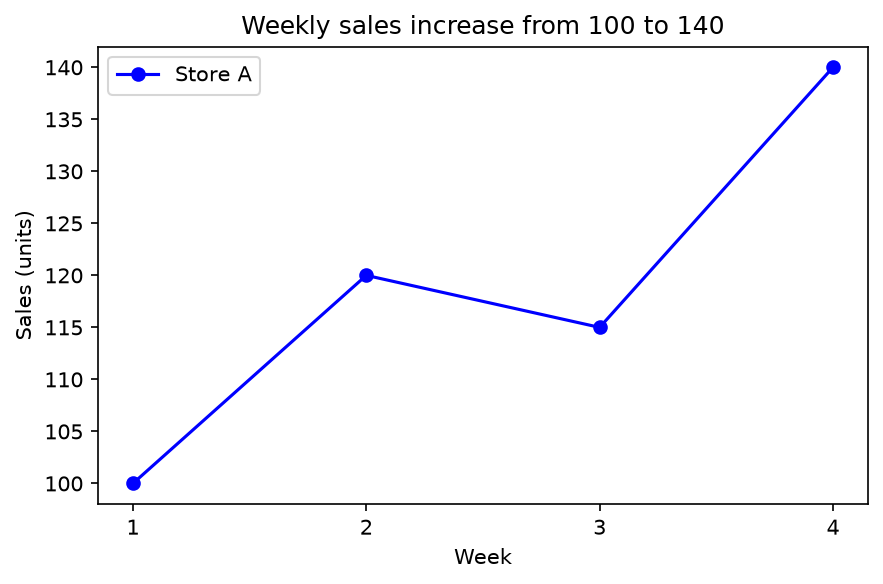
figsize=(宽,高) 的默认单位是英寸,不是像素。label= 定义图例文字,通常还需要调用 legend() 才显示。线型可用 linestyle="dashed",点形可用 marker="s"。
正文用中文解释即可;代码中的英文图标签便于跨环境显示。无需把绘图样式、颜色列表都抄到 cheatsheet。
3. 一张图里放多个子图
默认 squeeze=True 时:
| 创建方式 | 返回的第二个对象 | 访问方式 |
|---|---|---|
plt.subplots() | 单个 Axes | ax.plot(...) |
plt.subplots(1,2) | 一维 Axes 数组 | axes[0]、axes[1] |
plt.subplots(2,1) | 一维 Axes 数组 | axes[0]、axes[1] |
plt.subplots(2,3) | 二维 Axes 数组 | axes[行,列] |
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].plot([1, 2, 3], [4, 6, 5])
axes[0].set_title("Trend")
axes[1].bar(["A", "B"], [15, 20])
axes[1].set_title("Comparison")
fig.tight_layout()
plt.show()
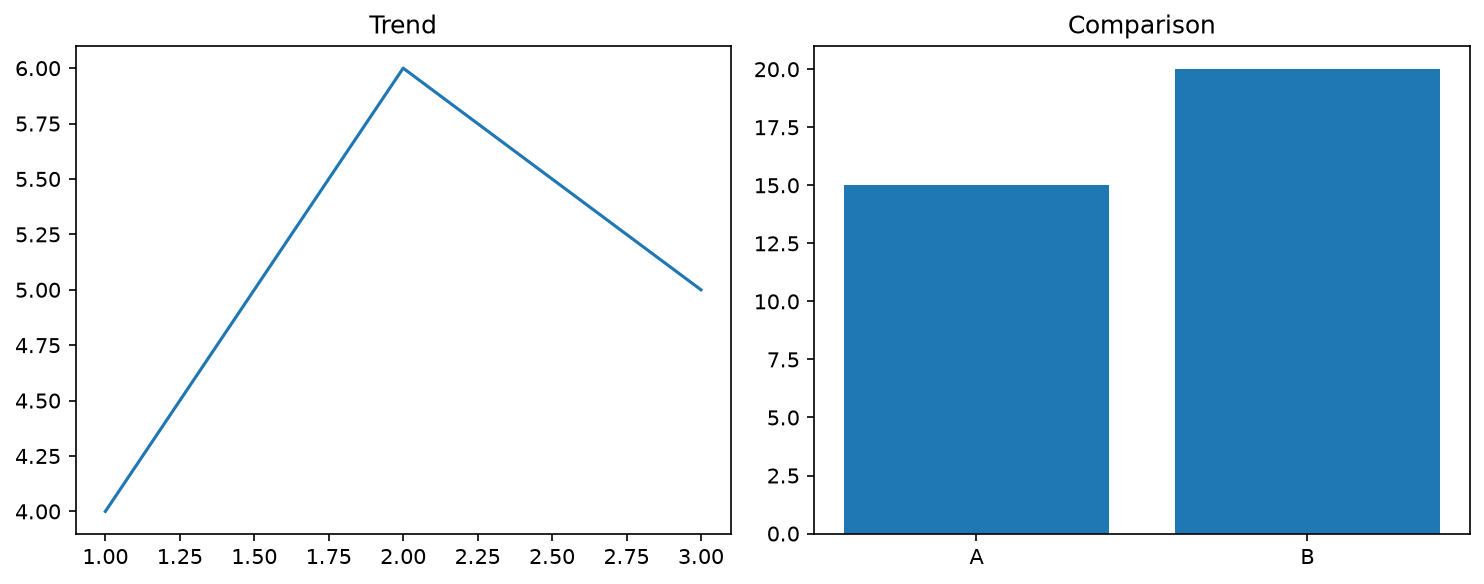
如果创建的是 plt.subplots(2,3),右下角用 axes[1,2],因为索引从 0 开始。
4. 不同问题选什么图
| 图形 | 适合回答的问题 | 典型 API | 读图重点 |
|---|---|---|---|
| 折线图(Line Plot) | 有序变量或时间上的变化趋势 | ax.plot(x,y) | 顺序、趋势、波动、拐点 |
| 柱状图(Bar Plot) | 比较离散类别的数量或统计量 | ax.bar(x,height) | 类别间差异、单位、基准 |
| 直方图(Histogram) | 一个数值变量如何分布 | ax.hist(x,bins=...) | 中心、离散、偏态、多峰 |
| 箱线图(Box Plot) | 比较分布位置、离散程度与异常点 | ax.boxplot(x) | 中位数、四分位距、须、异常点 |
| 散点图(Scatter Plot) | 两个数值变量有什么关系 | ax.scatter(x,y) | 方向、强弱、非线性、群组 |
| 散点矩阵(Scatter Matrix) | 同时检查多组变量关系 | pd.plotting.scatter_matrix(...) | 非对角线成对关系、对角线单变量分布 |
折线连接意味着相邻点有顺序意义。若数据只是任意排列的国家或客户,连线很容易让人误以为存在时间或连续变化;比较类别通常用柱状图更直接。
类别频数可以先 value_counts(),再画柱状图。即使某个库允许给直方图传入类别,也应理解直方图的核心用途是将数值划分区间。
5. 柱状图与直方图的区别
柱状图的一根柱通常对应一个类别;直方图的一根柱对应一个数值区间(Bin)。直方图的箱数或箱宽会影响看到的分布形状。
import matplotlib.pyplot as plt
import pandas as pd

df = pd.DataFrame({
    "store": ["A", "A", "B", "B", "B"],
    "sales": [10, 12, 8, 15, 20],
    "customers": [5, 6, 4, 7, 10],
})
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
df.groupby("store")["sales"].sum().plot.bar(ax=axes[0])
axes[0].set_title("Total sales by store")
axes[0].set_ylabel("Sales")
df["sales"].plot.hist(bins=[0, 10, 15, 25], ax=axes[1])
axes[1].set_title("Distribution of transaction sales")
axes[1].set_xlabel("Sales per transaction")
fig.tight_layout()
plt.show()
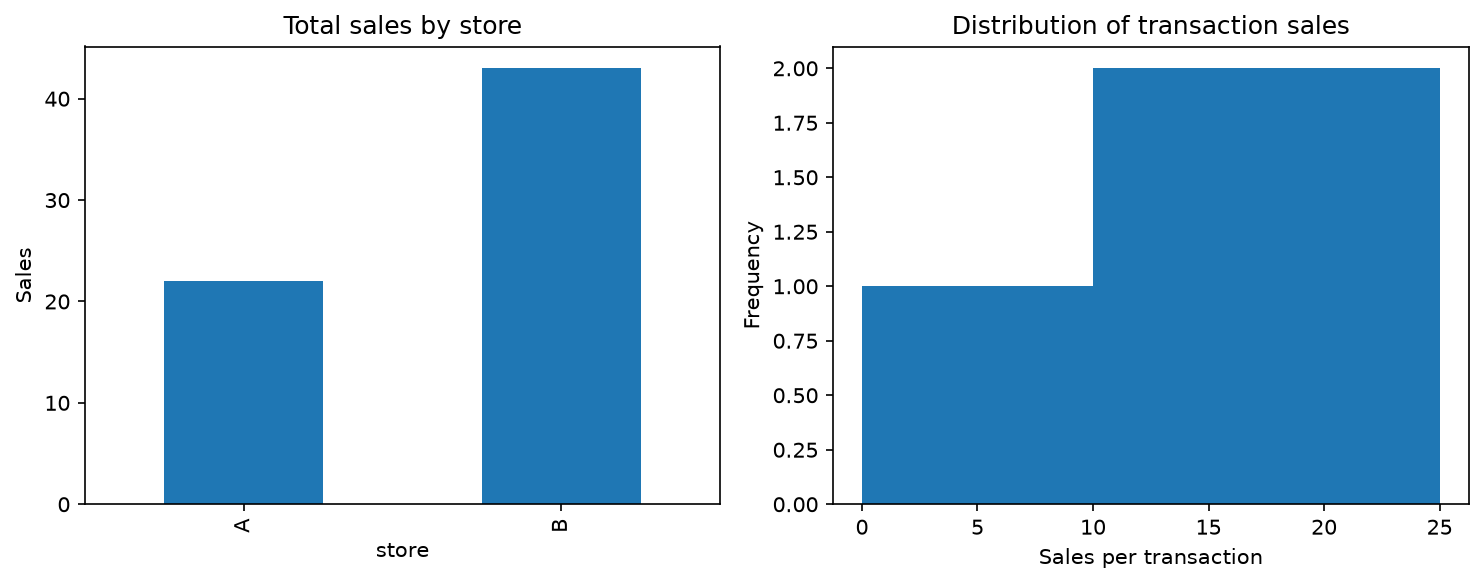
这两幅图分别回答什么? 假设上表一行是一笔交易,sales 是金额(元)。左图先按门店合计,柱高为 A=22、B=43 元,比较的是门店总收入;右图不分门店,将五笔金额 [10,12,8,15,20] 放入金额区间,比较的是交易金额分布。
右图显式指定区间边界 [0,10,15,25],三根柱分别计 [0,10)、[10,15)、[15,25],频数是 1、2、2 笔。柱高为 2 表示该区间有两笔交易,不表示收入为 2 元。ax=axes[1] 只决定画在右侧绘图区,不会筛选第二家门店。
Pandas 绘图默认基于 Matplotlib;传入 ax= 可以把图画在指定绘图区。默认频数直方图的柱高是落入区间的观测数;若改为密度(Density)图,应按面积解释,不能仍当作原始频数。
分布的基本读法:均值容易受极端值影响;右偏(Right-skewed)意味着较长尾部向右;少量分箱可能隐藏细节,过多分箱可能突出随机噪声。
6. 箱线图:必须记对的公式
设第一四分位数为 ,中位数为 ,第三四分位数为 :
- 箱体:从 到 ,表示中间约 50% 的数据范围。
- 箱内横线:中位数(Median),不是均值(Mean)。
- 须(Whiskers):默认延伸到围栏内最远的实际观测值,不一定正好等于围栏。
- 围栏外的点:按这一规则标记为异常点(Outliers / Fliers),不等于数据错误,也不意味着必须删除。
教师教程把异常值阈值写成了“中位数 ± 1.5IQR”;这里按 Matplotlib 默认定义使用上面的 围栏。不同软件或手算规则的四分位数定义可能不同,计算题应先看题目指定的约定。
import numpy as np

values = np.array([1, 2, 3, 4, 5, 6, 7, 8, 20])
q1, median, q3 = np.percentile(values, [25, 50, 75])
iqr = q3 - q1
lower, upper = q1 - 1.5 * iqr, q3 + 1.5 * iqr
outliers = values[(values < lower) | (values > upper)]
print(q1, median, q3, lower, upper, outliers)
# 3.0 5.0 7.0 -3.0 13.0 [20]
运行输出:
3.0 5.0 7.0 -3.0 13.0 [20]
不要把“作图时把异常点单独画出来”理解为“已经从原数据中删除”。对比不同分组时,箱体位置反映分布位置,箱体高度反映中间数据的离散程度;样本量不同仍需谨慎解释。
7. 散点图与相关性
fig, ax = plt.subplots()
df.plot.scatter(x="customers", y="sales", ax=ax)
ax.set_title("Sales and customer count")
plt.show()

# 多个数值特征的成对关系
pd.plotting.scatter_matrix(df[["customers", "sales"]], figsize=(6, 6))
plt.show()
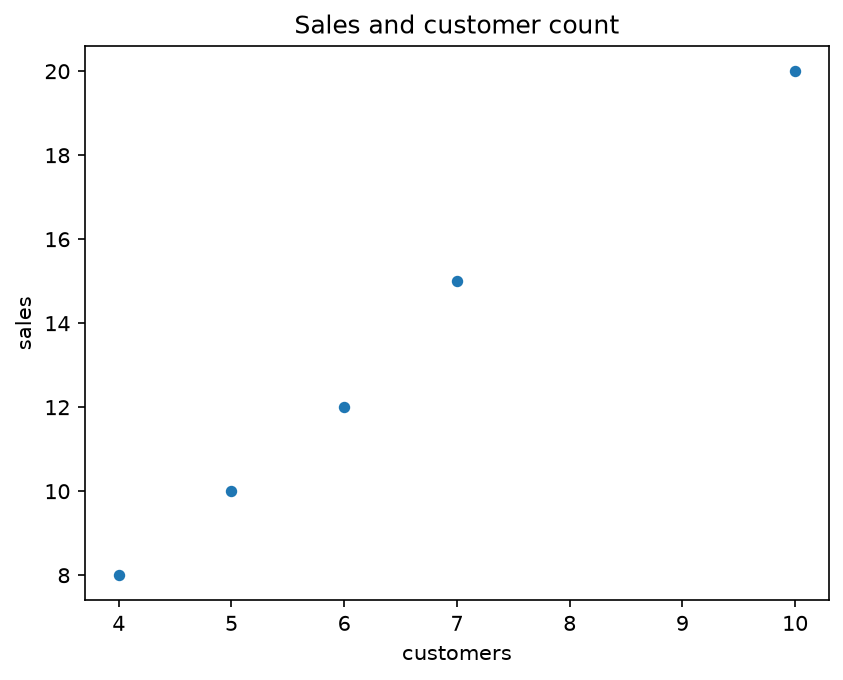
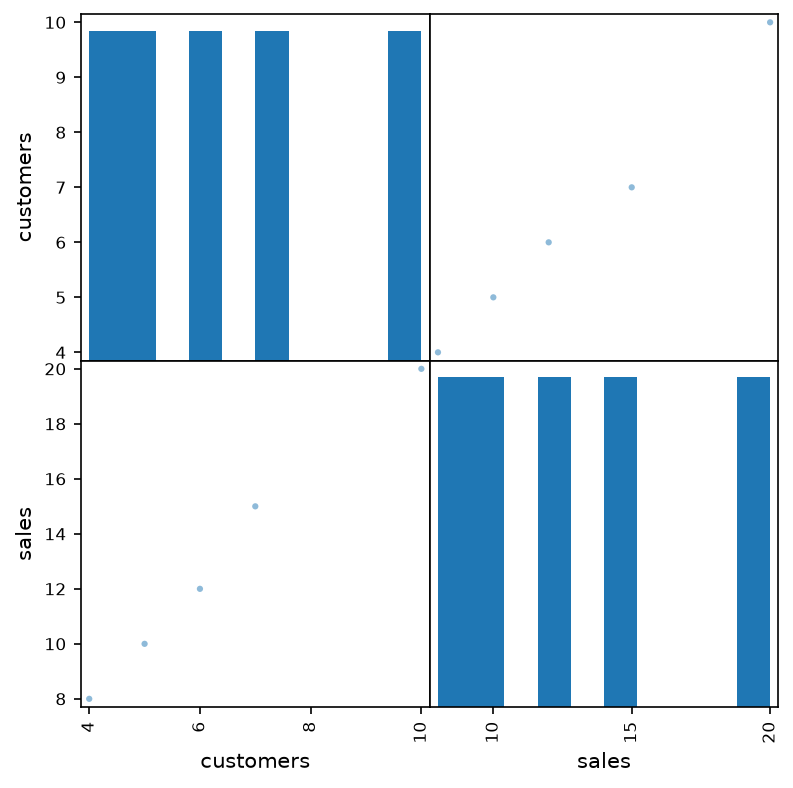
相关系数(Correlation Coefficient) 的范围为 。正相关表示一个变量较大时另一个往往也较大;负相关相反; 接近 1 表示较强的线性关系。
表示没有线性相关,不表示完全没有关系,也不保证独立(Independence)。 例如对称的 U 形关系可能线性相关很弱。散点图还能揭示分群、曲线、异常点,单个相关系数可能看不到这些结构。
相关性(Correlation)不能证明因果关系(Causation)。销售额与顾客数量相关不代表只增加顾客数量便必然按同样幅度提升利润;还需考虑客单价、成本及其他变量。
8. 纸笔例题与解答
题目。 对数组 [1,2,3,4,5,6,7,8,20],使用 NumPy 默认百分位计算方式,已得 、、。求四分位距、上下围栏、上下须端点及异常值。
解答。 ,围栏为 和 。围栏内最小观测为 1,最大为 8,所以须端点为 1、8。20 超过上围栏,是异常点。须端点不是 −3、13;中位数为 5,不能把它当均值。
9. 易错点与自测
常见错误:把 Axes 与 Axis 混淆;子图索引维度写错;把任意行号当时间;把直方图区间当类别;把箱内线当均值;把围栏当须端点;由相关性直接推出因果。
- 比较四家门店总收入,优先选哪种图?
- 检查客户收入分布是否右偏,优先选哪种图?
plt.subplots(2,2)返回的axes,右下角如何索引?- 、 时,上围栏是多少?值 29 是否越界?
- 两个变量相关系数为 0,是否可以断定彼此独立?
简答: 1. 柱状图。2. 直方图,也可辅以箱线图。3. axes[1,1]。4. ;29 没有越界。5. 不能,可能存在非线性关系。
课程来源
- Matplotlib 课程页
- 教师教程:Matplotlib 与 Pandas Charting
- Matplotlib 官方 boxplot 文档(核对默认围栏和须)
- Assignment 1:图表需服务于商业问题
本章小数据、纸笔例题与自测为复习自编。
06 基线与 Kaggle(Kaggle and Model-Free Prediction)
本章对应课堂的规则预测(Rule-Based Prediction)与启发式挑战(Heuristic Challenge)。复习目标:能解释为什么先做基线,能根据分组统计写规则,能识别提交文件和评估方式中的错误。
1. 从业务判断到基线
基线(Baseline)是衡量后续方法是否值得使用的参照。分类问题可以始终预测训练集中的多数类;回归问题可以始终预测训练目标的均值。基线并不保证很准,但提供了“复杂模型究竟改善了多少”的比较起点。
无模型预测(Model-Free Prediction)在本课中指直接由人编写规则,而不调用学习算法拟合参数。例如,根据训练数据的分组存活率,写出“女性预测存活、男性预测未存活”。规则仍然利用了数据中的信息。
启发式(Heuristic)是依据经验或数据现象制定的简便规则,不意味着它在所有样本上都正确。
| 方法 | 规则从哪里来 | 例子 | 需要检查什么 |
|---|---|---|---|
| 常数基线 | 训练目标的总体分布 | 所有人预测不取消 | 类别是否不平衡 |
| 分组规则 | 训练数据的分组统计 | 按性别预测存活 | 小样本组是否可靠 |
| 条件组合规则 | 人工结合多个特征 | 长提前期且无押金则预测取消 | 条件优先级、覆盖范围 |
| 训练后的模型 | 算法从训练数据学习 | 决策树自动选择切分 | 是否过拟合、评估是否公平 |
2. Kaggle 的三个文件
| 文件 | 是否有目标值 | 用途 |
|---|---|---|
train.csv | 通常有 | 探索数据、拟合规则或模型;也可划分本地验证/测试集 |
test.csv | 通常没有 | 为每一行生成预测,提交到平台 |
sample_submission.csv | 只有格式示例 | 检查列名、ID、目标格式和行数 |
Kaggle 的 test.csv 不等于本地测试集(Local Test Set)。 本地测试集通常从有标签的 train.csv 划出,因此我们能计算分数;Kaggle 测试文件的真实标签由平台保管,单靠该文件不能计算准确率。
Titanic 提交表需要 PassengerId 和 Survived 两列,其中 Survived 为整数 0 或 1。不要把 DataFrame 的索引额外导出成第三列。
3. 课堂 Titanic 的两条规则
课堂数据中,整体存活率约为 38.4%,所以多数类基线是全部预测 0。女性存活率约 74.2%,男性约 18.9%,由此得到第二条按性别预测的规则。
这些比例描述的是课堂给出的训练样本。它们不是业务规律的证明,也不保证未来数据保持同样比例。复习重点是从统计结果到规则的推理方式,无需死记某次排行榜分数。
准确率(Accuracy)的定义为:
两种规则必须在相同评估数据上比较。训练集准确率与另一规则的测试集准确率不能直接作为公平胜负依据。
4. 最小代码:先看分布,再写规则
以下为自建教学数据,并非完整 Titanic 数据。
import pandas as pd

train = pd.DataFrame({
    "Sex": ["male"] * 6 + ["female"] * 4,
    "Survived": [0] * 6 + [1, 1, 1, 0],
})

print(train["Survived"].value_counts(normalize=True))
print(train.groupby("Sex")["Survived"].mean())

# 训练多数类为 0
pred_constant = pd.Series(0, index=train.index)
pred_gender = train["Sex"].eq("female").astype(int)

print(pred_constant.eq(train["Survived"]).mean())  # 0.7
print(pred_gender.eq(train["Survived"]).mean())    # 0.9
运行输出:
Survived
0    0.7
1    0.3
Name: proportion, dtype: float64
Sex
female    0.75
male      0.00
Name: Survived, dtype: float64
0.7
0.9
因为 Survived 是 0/1,组内均值正好等于组内正类比例。上述两个分数只是训练样本上的描述,尚不能证明性别规则在新数据上一定更好。
下面演示提交格式,运行后会在当前目录生成 submission.csv。
test = pd.DataFrame({
    "PassengerId": [892, 893, 894],
    "Sex": ["male", "female", "male"],
})

submission = pd.DataFrame({
    "PassengerId": test["PassengerId"],
    "Survived": test["Sex"].eq("female").astype(int),
})

assert len(submission) == len(test)
assert submission["PassengerId"].equals(test["PassengerId"])
assert submission["Survived"].isin([0, 1]).all()
submission.to_csv("submission.csv", index=False)
导出的 CSV 内容:
PassengerId,Survived

892,0

893,1

894,0
这里假定 Sex 已检查且只有 male、female。实际数据若有缺失或其他取值,应事先指定合理的默认规则,不能让未知值无意中被当成男性。
若要练习课堂的 .apply(),等价写法为:
def survival_by_gender(sex):
    return int(sex == "female")  # 已确认仅有两类

prediction = test["Sex"].apply(survival_by_gender)
5. 启发式挑战的完整思路
以酒店取消(Cancellation)为例,先明确正类 Canceled = 1,再执行以下步骤:
- 看总体取消比例,建立全部不取消的常数基线。
- 按渠道、押金类型等分组,看取消率以及每组样本数。
- 对提前预订天数等数值变量尝试有业务意义的区间。
- 把发现写成少量可解释的条件,明确条件冲突时的优先级。
- 在保留的验证数据上比较规则,并记录改动理由。
- 为所有待预测订单输出结果,检查 ID 与提交格式。
例如,lead_time > 100 与 deposit_type == "No Deposit" 是两个条件,组合时要用括号:
bookings = pd.DataFrame({
    "booking_id": ["B01", "B02", "B03"],
    "lead_time": [30, 120, 150],  # 预订到入住的天数
    "deposit_type": ["No Deposit", "No Deposit", "Non Refund"],
})
risky = (bookings["lead_time"] > 100) & (
    bookings["deposit_type"] == "No Deposit"
)
rule_prediction = risky.astype(int)
print(rule_prediction.tolist())  # [0, 1, 0],1 表示预测取消
运行输出:
[0, 1, 0]
上面三行是自建订单:B01 没超过 100 天,输出 0;B02 同时满足两个条件,输出 1;B03 虽提前 150 天,但押金类型不匹配,仍输出 0。& 要求两项都成立,.astype(int) 再把布尔值转成提交需要的 0/1。此处只有预测,没有真实取消标签,所以不能直接计算这三行的准确率。
阈值 100 只是示意,不是课程指定的最优阈值。样本很少的组出现 100% 取消率,并不能说明该规则值得推广。
6. 手算例题:高准确率是否足够
自建例题。 验证集有 100 个订单,其中 80 个未取消、20 个取消。规则 A 全部预测未取消;规则 B 正确找出 12 个取消订单,同时把 6 个未取消订单误报为取消。
规则 A 的正确数为 80,准确率为 80%。规则 B 的正确数为:
规则 B 在这个验证集上准确率更高。若误报和漏报损失不同,还应比较业务成本;第 09 章会计算这一点。规则 A 的 80% 也说明了类别不平衡(Class Imbalance)可能让“不做区分”的预测看起来很好。
7. 常见失分点
- 删除 Kaggle 测试数据的缺失行:会造成部分 ID 没有预测。应采用适当填充等方式保留待预测行。
- 独热编码后只比较列数:即使列数相同,列名或顺序也可能不同。
- 用测试数据决定均值、阈值或类别映射:标准流程应从训练数据学习这些内容,再应用到后续数据。
- 不断根据公共排行榜调规则:也可能对公共测试部分过拟合,排行榜分数并非永远可信的独立检验。
- 看到模型训练准确率更高就认为优于规则:应比较同一验证集或同一交叉验证设置下的结果。
- 认为规则简单就没有过拟合:大量试阈值、试组合也可能拟合验证集噪声。
8. 纸笔自测
train.csv中 90% 的标签为 0。全部预测 0 是否说明模型已能识别正类?- Kaggle 的
test.csv没有目标列,为什么仍称为测试数据?我们能直接计算准确率吗? - 导出提交文件时
index=False的作用是什么? - 两条规则分别在不同验证划分上得到 0.81 和 0.82,能直接断定第二条更好吗?
- 某训练组只有 2 个样本且全为正类,把未来所有该组样本预测为正类有什么风险?
自测答案
- 不能。它在相同类比例的样本上可得到 90% 准确率,但正类召回率为 0。
- 平台用隐藏标签评估提交结果;本地没有真实标签,不能直接计算准确率。
- 不把 DataFrame 行索引写入 CSV,避免多出不需要的列。
- 不能。样本难度和随机划分不同,应在同一评估设置下比较。
- 组内比例非常不稳定,可能只是偶然现象;需要更多证据和独立验证。
9. 来源与复习边界
排行榜反复调试与验证集可比性属于帮助理解泛化的整理说明。考试具体题目与各章权重尚未公布。
07 数据预处理(Data Preprocessing)
本章四条主线是缺失值(Missing Values)、异常值(Outliers)、标准化(Standardization)和类别编码(Categorical Encoding)。所有操作都要回答:为什么这样处理、从哪些数据学习规则、预测新样本时怎样保持一致。
1. 缺失值:先检查,再决定
缺失率是某列缺失数量除以样本总数。isna() 与 isnull() 在这里作用相同;字符串 "?"、"unknown" 不会自动成为缺失值,需要按数据定义清理。
import numpy as np
import pandas as pd

df = pd.DataFrame({
    "age": [20.0, 30.0, np.nan, 40.0],
    "city": ["A", "B", np.nan, "A"],
})
print(df.isna().sum())   # 两列都缺 1 个
print(df.isna().mean())  # 两列缺失率都为 0.25
运行输出:
age     1
city    1
dtype: int64
age     0.25
city    0.25
dtype: float64
| 方法 | 适用判断 | 主要代价或限制 |
|---|---|---|
| 删除列 | 缺失很多且信息价值有限 | 丢失整列信息,不能只看缺失率 |
| 删除行 | 少量行缺失,且删除不会明显改变样本结构 | 减少数据,可能造成选择偏差 |
| 均值填充(Mean Imputation) | 数值列,均值有代表性 | 容易受极端值影响 |
| 中位数填充(Median Imputation) | 数值列,分布偏斜或有极端值 | 不能恢复真实个体差异 |
| 众数填充(Most-Frequent Imputation) | 数值或类别列 | 增加最常见取值的比例 |
| 常数填充(Constant Imputation) | 有明确业务含义的占位值 | 如用 0,须区分“真实为零”和“未知” |
| 前向/后向填充(Forward/Backward Fill) | 顺序有意义且相邻值适合沿用 | 不能随意跨客户、跨实体填充 |
填充值是估计,不等于真实值;填充后缺失数变成 0,不代表数据问题完全解决。
# 只演示各语句的作用,不要求依次执行
rows_kept = df.dropna(subset=["age"])
column_removed = df.drop(columns=["city"])
filled = df.assign(age=df["age"].fillna(df["age"].median()))

# 显示本例需要观察的结果
print(filled.to_string())
运行输出:
age city
0  20.0    A
1  30.0    B
2  30.0  NaN
3  40.0    A
dropna() 默认会删除含有任意缺失值的行;删除后如果特征 X 和目标 y 不同步,可能发生样本错配。应保留一致的行标识与索引。
2. 拟合与转换:训练数据决定规则
拟合(Fit)学习数据相关的参数;转换(Transform)使用已学到的参数处理数据。
| 预处理器 | fit 学到什么 | transform 做什么 |
|---|---|---|
| 填充器(Imputer) | 每列均值、中位数或众数 | 用这些值补缺失 |
| 标准化器(Scaler) | 每列均值、标准差 | 按同一尺度转换 |
| 编码器(Encoder) | 已见类别与输出列映射 | 把新样本映射到相同列空间 |
先划分数据,再仅在训练部分拟合。 验证集、测试集使用同一个已拟合的预处理器。交叉验证中,每一折都必须只用该折的训练部分重新拟合预处理器。
如果先对全体数据填充、标准化,再做交叉验证,验证折的信息已进入预处理参数,形成数据泄漏(Data Leakage)。即使操作没用到目标值,也可能使评估偏乐观。
from sklearn.impute import SimpleImputer

train_age = np.array([[10.0], [20.0], [np.nan], [30.0]])
test_age = np.array([[np.nan], [100.0]])

imputer = SimpleImputer(strategy="mean")
train_filled = imputer.fit_transform(train_age)
test_filled = imputer.transform(test_age)
print(imputer.statistics_)  # [20.]
print(test_filled.ravel())  # [20., 100.]
运行输出:
[20.]
[ 20. 100.]
测试集的 100 不参与计算填充值。课程早期决策树示例为了演示曾使用测试集自身的均值;完整建模时采用这里的训练统计原则。
字符串类别不能用默认的均值填充器。应明确写成:
cat_imputer = SimpleImputer(strategy="most_frequent")
cat_values = cat_imputer.fit_transform(df[["city"]])

# 显示本例需要观察的结果
print(cat_values)
运行输出:
[['A']
 ['B']
 ['A']
 ['A']]
追踪填补前后的一条客户记录。 把本节 train_age 理解为四位历史客户的年龄列,第四位为 30 岁,第三位未填;test_age 是两位待预测客户,其中第一位未填、第二位为 100 岁。训练数据的已知年龄为 10、20、30,故只学到一个填充值 20。输出仍为四行训练数据、两行测试数据,行序不变,仅缺失位置被替换。
fit_transform(train_age) 同时做“学规则”和“应用规则”;transform(test_age) 只做后者。填补器没有推断出新客户实际 20 岁,它只给模型提供按既定规则补齐的输入。
3. 异常值:偏离常态不等于错误
异常值可能来自单位错误、录入错误,也可能是真实的高价值客户或极端事件。删除前应先解释其来源及业务意义。
标准分数(Z-score)为:
z=2 表示高于均值两个标准差;z=-1 表示低于均值一个标准差。课堂用 作为一种异常识别规则,它是启发式标准,并非所有分布都适用的真理。
s = pd.Series([10.0, 12.0, 14.0, 16.0])
z = (s - s.mean()) / s.std(ddof=0)
suspect = z.abs() >= 3

# 显示本例需要观察的结果
print("z:", z.round(3).tolist())
print("suspect:", suspect.tolist())
运行输出:
z: [-1.342, -0.447, 0.447, 1.342]
suspect: [False, False, False, False]
计算口径提醒: Pandas 的 .std() 默认 ddof=1;NumPy 的 np.std() 默认 ddof=0。小样本时结果可能明显不同。题目给定标准差时直接使用给定值;需要复现计算时统一口径。
箱线图(Box Plot)的常见异常界限:
不是“中位数上下各 ”。箱须通常画到界限以内最远的实际观测值,不一定正好画到公式计算出的界限。
课堂示范删除异常值后重新计算 z-score,是因为数据的均值和标准差已改变。不能由此推导出“应反复删除,直到所有点都合格”;反复筛选可能持续损失真实样本。
建模时也不能为了得到好看的测试分数,看到预测困难的测试点就删去。若训练数据确需过滤,规则应有业务依据,并保持 X 与 y 对齐。
4. 标准化:统一尺度,不改变分布形状
标准化后的训练特征通常均值为 0、方差为 1;它不会自动把偏斜分布变成正态分布(Normal Distribution)。常数列无法除以非零标准差,库会作相应处理;不要把“所有列方差必为 1”当作无条件结论。
为什么要标准化:年龄、收入、面积的量纲和数量级不同,可能影响梯度下降的优化速度,也会影响依赖距离或系数尺度的算法。
决策树通常不需要标准化,因为对一个特征作保持次序的线性变换不会改变可切分的样本次序。课程流水线保留标准化,是为了展示通用预处理结构。
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
train_z = scaler.fit_transform(train_filled)
test_z = scaler.transform(test_filled)
沿用上面的年龄数据,填补后的训练列是 [10,20,20,30],均值为 20,总体标准差约 7.071。因而测试中的缺失年龄先补成 20,再转成 0;100 岁则转成约 11.314:
print(np.round(train_z.ravel(), 3))  # [-1.414 0. 0. 1.414]
print(np.round(test_z.ravel(), 3))   # [0. 11.314]
运行输出:
[-1.414  0.     0.     1.414]
[ 0.    11.314]
顺序是“先补年龄,再按训练尺度换算”。100 岁变成很大的标准分数,提醒我们检查该输入是否合理;缩放不会自动删去它,也不会强制把它限制在某个区间。
注意:测试集变换后不要求均值也等于 0、方差也等于 1,因为使用的是训练集参数。若为了达到这两个数重新 fit 测试集,就改变了模型看到的坐标系。
手算例题。 训练集某特征均值为 50,标准差为 10。新样本值 65 对应 。树中若有条件 z <= -0.5,还原为原单位即 。
5. 类别编码:整数标签不等于数值大小
顺序编码(Ordinal Encoding)把类别映射成整数。如果类别本身有顺序,例如低、中、高,指定有意义的顺序通常合理。如果类别没有顺序,例如城市 A、B、C,编码成 0、1、2 可能引入不合理的大小关系或限制切分方式。
独热编码(One-Hot Encoding)为每个类别建立指示列。例如城市 B 表示为 [0, 1, 0]。通常不应把它理解成连续数量。
city = pd.Series(["A", "B", "C", "A"], name="city")
print(pd.get_dummies(city, dtype=int))
运行输出:
A  B  C
0  1  0  0
1  0  1  0
2  0  0  1
3  1  0  0
| 原始类别 | A | B | C |
|---|---|---|---|
| A | 1 | 0 | 0 |
| B | 0 | 1 | 0 |
| C | 0 | 0 | 1 |
类别很多时,独热编码会产生大量列。可以依据业务知识合并类别;不要仅为减少列数任意合并有明显业务差异的取值。课程提到降维,但不需要在本章自行扩展到主成分分析的推导。
独立对训练集和测试集调用 get_dummies(),可能得到不同的列集合。更稳妥的通用方式是拟合编码器后重用它:
from sklearn.preprocessing import OneHotEncoder

encoder = OneHotEncoder(handle_unknown="ignore", sparse_output=False)
train_cat = np.array([["A"], ["B"], ["A"]])
test_cat = np.array([["B"], ["C"]])

encoder.fit(train_cat)
print(encoder.get_feature_names_out(["city"]))
print(encoder.transform(test_cat))
# B -> [0., 1.];未知 C -> [0., 0.]
运行输出:
['city_A' 'city_B']
[[0. 1.]
 [0. 0.]]
为什么 B 变成 [0,1],C 变成 [0,0]? 训练时只出现 A、B,因此输出两列 city_A、city_B,而不是为未来每个可能的城市预留一列。新客户来自 B,就填“不是 A、是 B”;C 在训练中没见过,指定忽略未知类别后,两列都为 0。增加新样本不会自动增加第三列,否则已训练模型的输入列数就对不上了。
handle_unknown="ignore" 解决未知类别的转换报错问题,不会让模型自动学会未知类别的行为。上述“全零”是该原始特征对应的编码块,不是把整个样本变成零。
6. 预处理顺序与代码阅读
典型数值分支:缺失填充 → 标准化。典型类别分支:缺失填充 → 独热编码。两条分支合并后送入模型,见第 09 章的完整流水线(Pipeline)。
从字符串转换数值时,pd.to_numeric(..., errors="coerce") 会把无法解析的值变成缺失值,因此后续仍需检查与处理。Pclass 虽然存成整数,也可以按业务意义作为类别特征;数据类型与特征的统计含义不是一回事。
7. 纸笔自测
- 训练收入为
[10, 20, 30, NaN],测试收入为[100, NaN]。均值填充时,测试缺失值应填多少? - 标准化能否消除偏态?标准化后的测试集均值必须为 0 吗?
- ,常用箱线图异常上下界是多少?
- 为什么应把填充器放进交叉验证的流水线,而不是先填完整份数据?
- 对城市编码为 0、1、2,相比独热编码可能引入什么问题?
自测答案
- 20,使用训练集非缺失值的均值。不能用测试集中的 100 来填。
- 均不能保证。标准化是中心化与缩放,测试集使用训练参数。
- ,下界 ,上界 。
- 每个验证折的填充值只能由该折的训练数据学习,避免泄漏。
- 人为赋予类别顺序或距离;类别本身没有这些关系时会误导某些模型。
8. 来源与口径校正
- 课程:Data Preprocessing
- 课程:Decision Tree Prediction
- 课程:Full Pipeline
- 官方:StandardScaler:标准化的含义与训练参数。
- 官方:SimpleImputer:填充策略及默认值。
- 官方:Matplotlib boxplot:箱线图界限与箱须。
课件有关“标准正态分布”“中位数上下 1.5 IQR”的措辞在这里按上述定义校正;考试手算采用题目给定数据和明确的统计口径。
08 决策树(Decision Tree)
本章复习顺序:沿树预测 → 计算纯度与信息增益 → 选择切分 → 限制复杂度 → 读懂训练代码。掌握小型手算比记住完整树图更重要。
1. 一棵树如何做预测
根节点(Root Node)提出第一个问题;内部节点(Internal Node)继续检查特征;叶节点(Leaf Node)给出最终结果。一个样本从根出发,沿条件分支走到一个叶节点。
分类树(Classification Tree)输出类别,常用叶内多数类作为预测;predict_proba() 根据叶内类别比例返回概率,在使用样本权重时是加权比例。
回归树(Regression Tree)输出数值;在平方误差准则下,叶节点预测该叶内训练目标的均值。
分类与回归树(Classification and Regression Trees, CART)可处理两类任务。课堂的 ID3 例子可按类别作多分支切分,而 scikit-learn 的 CART 实现使用二叉切分,不要把所有树都想成同一种分支结构。
Fare <= 30 ?
├─ True:预测 0
└─ False:Age <= 10 ?
           ├─ True:预测 1
           └─ False:预测 0
例如 Fare=50, Age=8 最终预测 1;Fare=20, Age=8 在第一层就到达叶节点,不再检查年龄。上图为自建示意,不是课堂数据训练结果。
2. 不纯度、熵与基尼不纯度
纯度(Purity)描述节点中的类别是否一致。只有一个类别的节点是纯节点;类别分布越均匀,通常越不纯。
设节点中共有 个类别,第 类占比为 。
熵(Entropy):
约定 。二分类纯节点的熵为 0;两类各一半时熵为 1。多分类熵的最大值是 ,所以“熵最大为 1”只适用于这里的二分类情况。
基尼不纯度(Gini Impurity):
二分类纯节点的 Gini 为 0;各一半时为 0.5。不要把 Gini 与准确率混为一谈。
| 二分类比例 | 熵 | Gini | 解释 |
|---|---|---|---|
| 1 与 0 | 0 | 0 | 完全纯 |
| 0.5 与 0.5 | 1 | 0.5 | 最不纯 |
| 0.8 与 0.2 | 约 0.722 | 0.32 | 比各半更纯 |
scikit-learn 的 DecisionTreeClassifier 默认准则为 gini;课堂手算重点是 entropy。API 的另一个取值写作 "log_loss",中间有下划线。
3. 信息增益必须按子节点大小加权
父节点有 个样本,切分为多个子节点,第 个子节点有 个样本,其熵为 。信息增益(Information Gain)为:
比较同一父节点的候选切分,选择信息增益最大的切分,也就是切分后加权熵最小的切分。子节点数量不相同时,不能简单对其熵取算术平均。
如果采用 Gini,则把公式里的熵换成 Gini,得到对应的不纯度下降(Impurity Decrease)。
手算例题:选择哪种切分
以下是自建频数表。父节点有 10 个样本,正类 6 个、负类 4 个。
| 候选切分 | 左子节点:正/负 | 右子节点:正/负 |
|---|---|---|
| A | 4 / 0 | 2 / 4 |
| B | 3 / 2 | 3 / 2 |
父节点熵:
A 的左子节点纯,熵为 0;右子节点熵为:
于是:
B 的两个子节点比例都与父节点相同,故加权熵仍为 0.971,。应选择 A。
若改用 Gini,父节点为 ,A 的加权子节点 Gini 为 ,下降约 0.213。这里两种准则都选择 A,但一般不保证所有候选切分的排序相同。
4. 对应课堂 Golf 数据的关键结果
课堂 Golf 数据有 9 个 yes、5 个 no,父节点熵约 0.940。按 Outlook 分组后的频数为:
| Outlook | yes | no | 总数 |
|---|---|---|---|
| sunny | 3 | 2 | 5 |
| overcast | 4 | 0 | 4 |
| rainy | 2 | 3 | 5 |
按原始比例计算,加权熵为 ,保留三位小数为 0.694,信息增益约 0.247。课件显示的 0.693 是近似展示,手算以原始比例计算为准。
Outlook 在该例中优于 Humidity、Windy、Temp,所以成为根节点。后续只在相应子集内重新计算:
overcast全为yes,直接成为叶节点。sunny按Windy切分后变纯。rainy按Humidity切分后变纯。
不同教材的经典 Golf 表可能交换 sunny 与 rainy 的命名;做本课题目应使用本课给定频数,不要套用背熟的另一张表。
5. 数值特征的切分点
对排序后的不同取值,可以考虑相邻不同值的中点。例如 [10, 20, 20, 40] 的候选中点为 15 和 30,而不是在重复的 20 之间制造有效分组。
每个候选阈值都形成“”与“”两个子集,再计算不纯度下降。也可先分箱(Binning),把数值转成区间类别,但可能损失细节。
贪心算法(Greedy Algorithm)在当前节点选择最佳切分,不保证得到所有可能树中全局最优的一棵树。
6. 为什么要剪枝
不断切分通常能降低训练误差,却可能记住偶然差异,导致过拟合(Overfitting)。限制树的复杂度属于正则化(Regularization);虽然后续“多项式回归与正则化”章节被排除,树的剪枝仍在本章范围内。
预剪枝(Pre-pruning)在生长时限制树:
| 参数 | 含义 | 通常使树更简单的方向 |
|---|---|---|
max_depth | 根到叶最多经过多少层分裂 | 减小 |
min_samples_split | 节点至少包含多少样本才可尝试切分 | 增大 |
min_samples_leaf | 任一叶节点至少有多少样本 | 增大 |
max_leaf_nodes | 最多允许多少叶节点 | 减小 |
min_impurity_decrease | 允许切分所需的最低加权不纯度下降 | 增大 |
在二叉树中,根深度记为 0,max_depth=3 至多产生 个叶节点;实际可能更少。浅树也可能含只覆盖一个样本的叶节点,因此深度限制与最小叶样本量不是同一约束。
min_impurity_decrease 的库实现还考虑当前节点占全部训练样本的权重;不要无条件把它等同于未加权的局部 。
默认不限制深度的树不保证所有叶节点都纯。例如两行特征完全相同但标签相反,就无法再通过特征将它们分开。默认树训练准确率可能达到 1,但不能据此保证测试表现。
后剪枝 ccp_alpha:课程标为可选(Optional)
代价复杂度剪枝(Cost-Complexity Pruning)权衡拟合误差与叶节点数量:
其中 是叶节点按样本占比加权的不纯度, 为叶节点数。更大的 ccp_alpha 使额外叶节点更“昂贵”,通常得到更小的树。具体最优值要由验证或交叉验证选择。
本小节在课件中标为可选;考试页没有单独明确排除,建议至少掌握方向和含义。
7. 最小训练代码与输出解释
以下代码使用自建数据,目的是读懂 fit、predict 和叶节点概率。
import pandas as pd
from sklearn.tree import DecisionTreeClassifier

X = pd.DataFrame({"fare": [5, 10, 20, 50, 60, 70]})
y = [0, 0, 0, 1, 1, 1]

model = DecisionTreeClassifier(
    criterion="entropy", max_depth=1, random_state=42
)
model.fit(X, y)

new = pd.DataFrame({"fare": [15, 55]})
print(model.predict(new))        # [0, 1]
print(model.classes_)            # [0, 1]
print(model.predict_proba(new))  # [[1., 0.], [0., 1.]]
print(model.get_depth())         # 1
print(model.get_n_leaves())      # 2
运行输出:
[0 1]
[0 1]
[[1. 0.]
 [0. 1.]]
1
2
把六条训练记录和两条新记录串起来看。 本例是人为简化的旅客数据:每行是一名旅客,fare 是票价,y=1 表示存活、0 表示未存活。低票价的三条标签均为 0,高票价的三条均为 1,因此深度为 1 的树可在 20 与 50 之间取中点 35 切分。
新旅客票价 15,满足 fare <= 35,进入左叶预测 0;票价 55 进入右叶预测 1。new 为 (2,1),predict(new) 是长度为 2 的类别数组,predict_proba(new) 为 (2,2):每行一名旅客,两列依 classes_ 对应类别 0、1。这里的极端概率来自小型纯叶,不表示现实中票价决定存活。
fit(X, y) 学习切分;predict(new) 使用已经学好的规则,不会重新训练。预测输入必须与训练时的特征定义和顺序一致。类别变量的编码与缺失值处理应纳入第 09 章的流水线。
叶中 100% 为某类,是当前训练数据支持的叶内比例,不表示未来预测具有绝对确定性。
8. 读树图的细节
- scikit-learn 图中
feature <= threshold条件成立走左分支,不成立走右分支。 Sex_female <= 0.5表示该独热列为 0,即不是已编码的female类。只有数据确实只有男/女两类时,才能直接称为男性。- 若数值特征先标准化,阈值也是标准化单位,需要按 还原。
samples表示到达节点的训练样本数量或比例,取决于作图选项;value的显示也受版本、权重和作图参数影响,应先读图例。class是节点的预测类别;entropy或gini是不纯度,不是预测错误率。
9. 纸笔自测
- 二分类节点有 5 个正类和 5 个负类,熵和 Gini 分别为多少?
- 两个子节点熵分别为 0 和 1,样本数分别为 90 和 10。加权熵是多少?
min_samples_split=10能否保证每个叶节点至少有 10 个样本?- 为什么训练准确率为 1 不能说明模型已经足够好?
- 一个叶节点有 3 个负类、7 个正类,在无权重设置下预测类别和正类概率是什么?
自测答案
- 熵为 1,Gini 为 0.5。
- ,不是 0.5。
- 不能。它限制父节点能否尝试切分;最小叶节点样本量由
min_samples_leaf控制。 - 可能记住训练集噪声,需用未参与拟合与选择的独立数据检验泛化。
- 预测正类 1,正类概率为 0.7。
10. 来源
09 模型评估与完整流水线(Model Evaluation and Full Pipeline)
本章把前面内容连接成完整流程:定义指标 → 划分数据 → 选择模型与参数 → 重新拟合 → 最终测试 → 解释预测依据。下文将课件及作业中的明确要求与可选内容分别标注。
1. 先定义正类,再读混淆矩阵
混淆矩阵(Confusion Matrix)比较真实类别与预测类别。下面约定取消订单为正类:Canceled = 1,未取消为负类:Canceled = 0。
| 实际值 \ 预测值 | 预测 0:未取消 | 预测 1:取消 |
|---|---|---|
| 实际 0:未取消 | 真负例(True Negative, TN) | 假正例(False Positive, FP) |
| 实际 1:取消 | 假负例(False Negative, FN) | 真正例(True Positive, TP) |
True/False 表示预测是否正确,Positive/Negative 表示预测成了哪一类。
- 假正例(FP):误报,实际没取消却预测取消;对应第一类错误(Type I Error)。
- 假负例(FN):漏报,实际取消却预测没取消;对应第二类错误(Type II Error)。
scikit-learn 在 labels=[0, 1] 时,行是真实值、列是预测值,排列为:
课堂部分表格把正类放在第一行和第一列,位置会变成 [[TP, FN], [FP, TN]]。先读标签顺序,不要只背四个格子的位置。
2. 四个核心分类指标
记 。
| 指标 | 公式 | 它回答什么 |
|---|---|---|
| 准确率(Accuracy) | 全部样本中判对多少 | |
| 精确率(Precision, P) | 预测为正的里面有多少真是正 | |
| 召回率(Recall, R) | 实际为正的里面找出了多少 | |
| F1 分数(F1 Score) | 精确率与召回率的调和平均 |
精确率的分母来自“预测正类”,召回率的分母来自“真实正类”。F1 不是 ,也不直接考虑 TN。
分母为 0 时,指标在数学上需要特殊处理。代码可设置 zero_division=0 采用明确的返回约定;不要把“没有预测正类”解释为精确率必然等于 1。
类别不平衡(Class Imbalance)时,准确率可能掩盖完全漏掉少数类的问题;应根据业务需求同时检查混淆矩阵、召回率、精确率与成本。
手算例题:指标与业务损失
自建例题,成本采用 Assignment 3。 某测试集有 100 个订单:
因此:
作业设定:酒店对预测会取消的订单超售;FP 导致客人到店却无房,成本约 400 美元;FN 导致空房,成本约 150 美元。因此:
若全部预测不取消,30 个实际取消订单全部成为 FN,成本为 。这个模型相对该基线节省 1000 美元。
FP 更贵,因此需要重视精确率,减少错误触发超售。但最终应比较总成本;不能只因精确率更高就无条件选模型,因为漏报数量也会变化。
最小指标代码
from sklearn.metrics import (
    confusion_matrix, accuracy_score,
    precision_score, recall_score, f1_score,
)

y_true = [0] * 70 + [1] * 30
y_pred = [0] * 65 + [1] * 5 + [0] * 10 + [1] * 20

cm = confusion_matrix(y_true, y_pred, labels=[0, 1])
tn, fp, fn, tp = cm.ravel()
print(cm)
print(accuracy_score(y_true, y_pred))
print(precision_score(y_true, y_pred, zero_division=0))
print(recall_score(y_true, y_pred, zero_division=0))
print(f1_score(y_true, y_pred, zero_division=0))
print(400 * fp + 150 * fn)  # 3500
运行输出:
[[65  5]
 [10 20]]
0.85
0.8
0.6666666666666666
0.7272727272727273
3500
3. 留出法:训练、验证、测试各司其职
留出法(Holdout Validation)把有标签数据分成不同部分。
| 数据部分 | 用途 | 可以据此做选择吗 |
|---|---|---|
| 训练集(Training Set) | 拟合模型、填充器、标准化器、编码器 | 可以 |
| 验证集(Validation Set) | 比较特征、模型、参数与阈值 | 可以 |
| 测试集(Test Set) | 选择结束后估计泛化表现 | 不用于后续选择 |
课程练习使用 60% / 20% / 20%。先取出总样本的 20% 作为测试集,再从剩余的 80% 中取出四分之一,得到总样本的 20% 作为验证集。
# 假设 X、y 已准备好,且每个类别有足够样本
from sklearn.model_selection import train_test_split

# X_dev, X_test, y_dev, y_test = train_test_split(
#     X, y, test_size=0.2, random_state=409
# )
# X_train, X_val, y_train, y_val = train_test_split(
#     X_dev, y_dev, test_size=0.25, random_state=409
# )
用人数理解两次拆分。 若原来有 1,000 条订单,第一次留下 200 条最终测试、800 条开发数据;第二次从 800 条里取 25%,即 200 条验证,剩 600 条训练。若第二次误写 test_size=0.2,只会取出 160 条验证数据,不能得到所需的 60%/20%/20%。X 与 y 同时传入,是为了让同一订单的特征和标签始终一起分到同一组。
这里保留课堂指定的随机划分方式;为了与作业的 2,709 个测试订单一致,不应自行添加 stratify 或提前删行。其他分类项目可考虑 stratify=y 保持类别比例,但那是另一种划分。
只看一次测试集的意义是:特征、预处理、参数和阈值都已固定。若根据测试结果修改模型,该数据实际上已参与选择,不能再把它当作完全独立的最终检验。
random_state 使随机划分可复现,不会让某个划分天然更可靠,也不应不断换种子直到分数最高。
补充理解:有时间先后关系或同一客户多行的数据,随机按行切分可能使信息跨集合流动,应根据预测场景考虑按时间或实体划分。此处用于理解泄漏,不扩展为新的考试章节。
4. 过拟合与欠拟合
| 状态 | 训练表现 | 验证表现 | 常见处理思路 |
|---|---|---|---|
| 欠拟合(Underfitting) | 较差 | 较差 | 更合适的特征、更有表达力的模型、减弱过强限制 |
| 过拟合(Overfitting) | 很好 | 明显较差 | 剪枝、减少不必要特征、更多有代表性的数据 |
| 泛化较好 | 较好 | 与训练表现接近且较好 | 继续检查稳定性与业务成本 |
这些是诊断线索,不是仅靠两行数字就能绝对判定的定理。训练和验证分数都低,也可能来自目标噪声、错误标签或不合适的指标。
交叉验证(Cross-Validation)帮助发现问题和选择参数;它本身不会把同一棵过深的树自动变简单。更多样本也不能保证修复一个表达能力不足的模型。
5. K 折交叉验证如何工作
先保留最终测试集。把剩余的开发数据(Development Data)划成 折:每轮用 折训练,剩下一折验证,轮流做 次,得到 个验证分数。
一次 5 折交叉验证中,每个样本作为验证样本一次,作为训练样本四次;每个模型只看到开发数据的约 80%。最终选定参数后,要用全部开发数据重新拟合(Refit),而不是随便取其中一折的模型作为最终模型。
cross_validate(..., scoring="accuracy") 返回 test_score;若使用多指标列表,例如 scoring=["accuracy", "f1"],则返回 test_accuracy、test_f1。这里的 test 指交叉验证的留出折,不是锁定的最终测试集。
设置 return_train_score=True 可获得每折训练分数,用于对比训练与验证差距。预处理器必须与模型一起放入流水线,让每折独立学习其训练部分的统计量。
具体到 800 条开发订单: 5 折各 160 条。第 1 轮用第 2–5 折的 640 条训练,在第 1 折 160 条上评分;第 2 轮换第 2 折验证。若比较深度 2 与深度 5,两种设置都使用相同五折,各得五个验证分数,再比较平均值。锁定的 200 条最终测试订单全程不参与这个比较。
6. 网格搜索:组合数、拟合次数、最优结果
网格搜索(Grid Search)穷举预先指定的超参数(Hyperparameters)组合,再用交叉验证比较。
例如 criterion 有 2 种、max_depth 有 5 种:
每组做 5 折交叉验证,需要 次拟合。在默认 refit=True 且正常完成时,最佳组合还会在全部传入训练数据上拟合一次:
课堂完整流水线的网格是:填充策略 2 种 × 准则 2 种 × 深度 5 种 × 分类填充策略 1 种,配合 10 折交叉验证,总计 次树拟合。若 refit=False,没有最后的 。
这里数的是模型拟合次数,不是不同超参数组合数;每次拟合还会学习对应流水线中的预处理参数。
| 属性 | 应如何理解 |
|---|---|
best_params_ | 最优超参数组合 |
best_score_ | 最优组合的平均交叉验证分数 |
cv_results_["mean_test_score"] | 每个候选组合各自的平均验证分数 |
best_estimator_ | 默认重新拟合后可直接预测的最佳模型/流水线 |
不要把所有候选组合的 mean_test_score 再取平均,当成最佳模型分数。课程有展示这个总体均值,但它与 best_score_ 回答的是不同问题。GridSearchCV 官方定义
参数路径使用双下划线:preprocessor__num_pipeline__imputer__strategy,表示依次进入预处理器、数值分支、填充器,再设置其 strategy。实际路径必须与自己定义的步骤名一致。
7. 可运行的完整流水线
下例用自建的 60 行旅客数据演示存活分类:一行一名旅客,Age 为年龄、Fare 为票价、Sex 为性别,target=1 表示本教学例子设定的存活标签。标签由下面的人工规则生成,只为演示代码,不代表真实 Titanic 数据或现实因果关系。本例的正类是存活,与前面酒店例子的“取消”含义不同。
需要解决的问题: 部分年龄与性别缺失,性别又不能直接作为字符串送入这段树训练代码;同时要比较填补策略与树参数,还要避免验证数据参与预处理。流水线将这些步骤绑在一起,每次给它原始旅客表即可。
import numpy as np
import pandas as pd
from sklearn.model_selection import (
    train_test_split, StratifiedKFold, GridSearchCV,
)
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, confusion_matrix

# 自建数据,先生成完整特征与标签
rng = np.random.default_rng(409)
n = 60
age = rng.integers(18, 70, size=n).astype(float)
fare = rng.uniform(10, 100, size=n)
sex = rng.choice(["female", "male"], size=n).astype(object)
target = (((sex == "female") & (age < 50)) | (fare > 70)).astype(int)
age[::11] = np.nan
sex[::13] = np.nan
X = pd.DataFrame({"Age": age, "Fare": fare, "Sex": sex})
y = pd.Series(target, name="target")

# 本示例使用分层划分,不复现作业指定测试集
X_dev, X_test, y_dev, y_test = train_test_split(
    X, y, test_size=0.2, random_state=409, stratify=y
)
num_features = ["Age", "Fare"]
cat_features = ["Sex"]

num_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
])
cat_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("onehot", OneHotEncoder(handle_unknown="ignore")),
])
preprocessor = ColumnTransformer([
    ("num_pipeline", num_pipeline, num_features),
    ("cat_pipeline", cat_pipeline, cat_features),
])
pipeline = Pipeline([
    ("preprocessor", preprocessor),
    ("tree", DecisionTreeClassifier(random_state=409)),
])

param_grid = {
    "preprocessor__num_pipeline__imputer__strategy": ["mean", "median"],
    "tree__criterion": ["gini", "entropy"],
    "tree__max_depth": [1, 2, 3, 4, 5],
}
cv = StratifiedKFold(n_splits=3, shuffle=True, random_state=409)
search = GridSearchCV(pipeline, param_grid, cv=cv, scoring="accuracy")
search.fit(X_dev, y_dev)

# 20 个组合 × 3 折 + 1 次重拟合 = 61 次
best = search.best_estimator_
print(search.best_params_)
print(search.best_score_)

# 选择完成后再评估测试集
prediction = best.predict(X_test)
print(accuracy_score(y_test, prediction))
print(confusion_matrix(y_test, prediction, labels=[0, 1]))
运行输出:
{'preprocessor__num_pipeline__imputer__strategy': 'mean', 'tree__criterion': 'gini', 'tree__max_depth': 4}
0.8958333333333334
1.0
[[6 0]
 [0 6]]
沿着一批数据追踪形状:
| 环节 | 本例输入/输出 | 每行或每列表示什么 |
|---|---|---|
原始 X、y | (60,3)、(60,) | 60 位旅客,3 个特征,各有一个标签 |
| 开发集/测试集 | 48 行 / 12 行 | 测试旅客留到选择结束后 |
| 一轮 3 折 CV | 32 行训练 / 16 行验证 | 本轮填补值、尺度和树只从 32 行学习 |
| 预处理后 | 本例每行 4 列 | 标准化年龄、标准化票价、female 指示列、male 指示列 |
| 最佳方案重新拟合 | 使用全部 48 行开发数据 | 重新学习整套预处理与树 |
best.predict(X_test) | (12,) | 按测试表行序输出 12 个存活类别 |
例如性别为 female 的旅客会进入类别分支,得到 [1,0];年龄缺失则进入数值分支,先用该次拟合学到的填充值补齐,再标准化。合并后的四列才送给树。四列的实际名字可以用下面的 get_feature_names_out() 检查,不能靠猜测拼接顺序。
拿到模型后,怎样预测一名新旅客?下面续接 best,无需重新 fit:
new_passenger = pd.DataFrame({"Age": [np.nan], "Fare": [80.0], "Sex": ["female"]})
new_prediction = best.predict(new_passenger)
print(new_prediction.shape)  # (1,),一位旅客对应一个预测
运行输出:
(1,)
这条调用会自动执行填补、缩放、编码和预测。不要先手工把它变成四列,再传给仍期待原始三列的 best。
这段代码值得逐层解释:
ColumnTransformer按列把数值特征和类别特征送入不同分支,再拼接输出。Pipeline按顺序执行各步骤,最后一步是模型。- 搜索的每个训练折都重新拟合填充器、标准化器、编码器和树。
best.predict(X_test)自动执行已经学好的预处理,再预测;不用手动重复填充与编码。- 分类填充器明确设为
most_frequent,所以即使不运行网格搜索也能处理字符串。
原课件的分类分支先写 SimpleImputer(),后来通过网格设成 most_frequent;如果只复制前半段直接 fit,默认 mean 会导致字符串填充失败。这里把可用策略直接写入分支。
8. 特征重要性:模型为什么这样预测
基于不纯度下降的重要性(Mean Decrease in Impurity, MDI)统计某个特征在树中所有切分带来的加权不纯度下降。
设训练集总样本数为 ,内部节点 有 个样本,左右孩子分别为 ;节点贡献为:
某个特征 的原始贡献为所有使用它的节点贡献之和,再除以所有特征的总贡献得到重要性:
存在有效分裂时,通常归一化为总和 1;若树完全没有分裂,重要性可以全为 0。上式为无样本权重情形;带权训练使用相应加权计数。
自建手算。 特征 A 在根节点贡献 0.20,又在一个子节点贡献 0.05;特征 B 贡献 0.15。总贡献 0.40,所以 ,。同一特征的贡献必须跨节点相加;根节点使用的特征不保证在所有树中都是最终最重要的。
编码后列数为什么更多
原始 3 个特征可能被变为 4 列:Age、Fare、Sex_female、Sex_male。重要性数组对应模型实际输入的编码后列,应按相同顺序取列名。
以下续接上一节的完整代码:
prep = best.named_steps["preprocessor"]
tree = best.named_steps["tree"]
names = prep.get_feature_names_out()

importance = pd.Series(tree.feature_importances_, index=names)
print(importance.sort_values(ascending=False))

# 将独热列按原始特征汇总
encoder = prep.named_transformers_["cat_pipeline"].named_steps["onehot"]
origins = num_features + [
    feature
    for feature, categories in zip(cat_features, encoder.categories_)
    for _ in categories
]
by_original = pd.Series(tree.feature_importances_).groupby(origins).sum()
print(by_original.sort_values(ascending=False))
运行输出:
num_pipeline__Fare          0.421692
cat_pipeline__Sex_male      0.299211
num_pipeline__Age           0.279096
cat_pipeline__Sex_female    0.000000
dtype: float64
Fare    0.421692
Sex     0.299211
Age     0.279096
dtype: float64
这里汇总代码适用于上例的“不丢弃类别、不合并低频类别、无全缺失列”设置。若变更编码策略,需要同步更新映射。不要简单取列名第一个下划线前的字符串:lead_time 这种原始名称本身就有下划线。
重要性不能说明什么
- 没有方向:0.6 的重要性不代表该特征越大,正类概率就越高。
- 不是因果效应(Causal Effect):能预测取消的变量,不一定是取消的原因。
- 不是个体解释:总体重要性不等于某一个订单的具体决策原因。
- 零重要性不等于无用:另一相关特征可能已承担同样的信息,或树太浅没有使用它。
- 不是无偏的通用排名:不纯度重要性可能偏向可切分取值多的特征,且相关特征会分担或替代贡献。
比较分组结果可辅助理解方向,但更细的条件关系应直接读树的分支,不能只用总体分组比例替代模型解释。发现预测时不可能获得的变量异常重要,例如“退款已发生”,还应排查泄漏。
9. 置换重要性:与后续回归内容衔接
置换重要性(Permutation Importance)固定已训练模型,将某一输入列的值随机打乱,观察分数下降:
它不需要重新训练模型,可用于多种模型。若使用 neg_root_mean_squared_error,分数下降对应 RMSE 增加。重要性接近 0 或小于 0 可能来自该特征贡献有限、噪声或样本波动;高度相关的特征可能互相替代,使各自的重要性偏低。置换重要性官方说明
以下代码续接已固定的 best,在测试集上只作最终报告解释;不能再据此筛特征、调模型后仍称该测试集完全独立。
from sklearn.inspection import permutation_importance

result = permutation_importance(
    best, X_test, y_test,
    scoring="accuracy", n_repeats=5, random_state=409,
)
print(pd.Series(result.importances_mean, index=X_test.columns))
运行输出:
Age     0.15
Fare    0.40
Sex     0.20
dtype: float64
打乱一列具体在做什么? 假设原始测试准确率为 0.85,把年龄在旅客之间随机交换后降至 0.78,则该次年龄重要性为 0.85−0.78=0.07,即下降 7 个百分点。旅客行、真实标签和其他特征都保留,只破坏年龄与对应旅客的配对。若重新训练模型,它就有机会适应被打乱的数据,回答的便不再是“现有模型有多依赖年龄”。这些数值仅为手算说明。
因为传入的是完整流水线与原始 DataFrame,这里直接得到原始列层面的重要性。若重要性用于选择特征,应在训练/验证流程内进行,最终测试数据继续保留。
10. 阈值、PR 与 ROC/AUC:课件标为可选
本节在课程页面标题中标为可选(Optional),考试页未单独声明排除。先掌握核心指标和评估流程,再复习本节定义与方向。
对模型返回的正类分数 ,可以规定阈值 : 时预测正类。概率列的顺序应查 classes_,不能对所有模型都假定第二列一定对应想要的正类。
提高阈值会使预测正类集合缩小,因此在同一组固定分数上,召回率不会上升;精确率通常会上升,但不保证单调上升。某一步若删除了较多真正例,精确率也可能下降。平票处理及默认预测规则可能依模型而异。
精确率—召回率曲线(Precision-Recall Curve, PR Curve)通常以召回率为横轴、精确率为纵轴,描述阈值变化下的表现。平均精确率(Average Precision, AP)可用作曲线的汇总指标;不必把它与所有实现中的几何面积完全等同。
受试者工作特征曲线(Receiver Operating Characteristic Curve, ROC Curve):
横轴是假正率(False Positive Rate, FPR),纵轴是真正率(True Positive Rate, TPR)。越靠近左上角通常越好。
曲线下面积(Area Under the ROC Curve, AUC)概括不同阈值下的排序能力:随机排序的期望约 0.5;完美排序为 1;也可能小于 0.5。更精确的概率解释是:随机选一正一负样本,正样本得分更高的概率,加上平分概率的一半。
计算 AUC 应使用概率或连续决策分数,而不是只传入最终 0/1 预测。AUC 高不保证当前阈值下成本低,也不直接保证概率校准准确。正类稀少时,应同时看 PR 曲线和业务指标,不能把 ROC/AUC 当作自动解决不平衡问题的办法。
# 续接上文 best;本例 classes_ 为 [0, 1]
from sklearn.metrics import roc_auc_score, precision_recall_curve

positive_column = list(best.classes_).index(1)
scores = best.predict_proba(X_test)[:, positive_column]
print(roc_auc_score(y_test, scores))
precision, recall, thresholds = precision_recall_curve(y_test, scores)
运行输出:
1.0
precision、recall 比 thresholds 多一个元素;画“阈值—指标”图时通常使用 precision[:-1] 与 recall[:-1] 配对阈值。
11. 纸笔自测
- 有
confusion_matrix(..., labels=[0,1]) = [[40,10],[5,45]],求准确率、精确率、召回率、F1。 - 某网格含 3 个深度、2 个准则、2 个填充策略,做 5 折交叉验证且默认重新拟合,共拟合多少棵树?
- 为什么
cv_results_["mean_test_score"].mean()不是最佳模型的交叉验证分数?test_score是否表示最终测试集分数? - 先用全体数据拟合标准化器,再对模型做交叉验证,有何问题?
- 某特征重要性为 0,能否立刻断定应删除?提高分类阈值能否保证精确率升高?
自测答案
- ;;;。
- 组合数 ;总拟合次数 。
- 它平均了所有候选组合;最佳组合对应
best_score_。CV 的test_score是验证折分数。 - 验证折数据已参与均值和标准差估计,形成泄漏;应把预处理放进每折的流水线。
- 均不能。重要性依赖当前模型和其他特征,应通过训练/验证流程检查删列效果;阈值升高时精确率可能局部下降。
12. 来源
- 课程:Model Evaluation Basics
- 课程:Model Evaluation and Selection
- 课程:Model Evaluation In-Class Exercise
- 课程:Model Tuning via Grid Search
- 课程:Full Pipeline
- 课程:Feature Importance
- 课程:Precision-Recall and ROC/AUC(Optional)
- 课程:Assignment 3,成本与流水线要求
- 官方:confusion_matrix 的行列定义
模型解释的边界、置换重要性及数据划分补充用于连接全课内容,不代表额外公布了考试题目或分值。
10 线性回归(Linear Regression)
复习目标:能写出预测式、核对矩阵维度、手算回归指标、解释系数,并区分“预测得准”和“业务赚钱”。正规方程推导与统计推断所在课程子页标为 optional;正文保留其边界。决定系数(R-squared)在作业 4 明确使用,应掌握定义与解释。
1. 模型在做什么
回归(Regression)预测数值目标,例如房价、二手手机价格;分类(Classification)预测类别,例如取消或不取消。
确定性函数关系(Functional relation)中,同一个输入直接决定输出;统计关系(Statistical relation)中,相同或相近输入仍可能有不同输出。线性回归用一条直线或一个平面概括总体趋势,允许残差存在。
单特征模型:
多特征模型:
| 符号 | 含义 | 示例 |
|---|---|---|
| 第 个特征(Feature) | 房龄、收入 | |
| 实际目标(Target) | 实际房价 | |
| 预测值(Prediction) | 预测房价 | |
| 系数/权重(Coefficient / Weight) | 特征变化对应的预测变化 | |
| 截距/偏置(Intercept / Bias) | 所有输入为 0 时的预测 | |
| 残差(Residual) | 实际值减预测值 |
两个特征的预测面是平面,更多特征对应超平面(Hyperplane)。课程把多个输入特征称为 multivariate regression;其他教材也常称 multiple regression。
2. 向量、矩阵与维度
设训练集有 行、 个特征,用列向量书写参数:
| 对象 | 数学形状 | 说明 |
|---|---|---|
| 每行是一条样本 | ||
| 每个特征一个权重 | ||
| 每条样本一个目标/预测 | ||
| 标量 | 同一个截距加到所有行 |
因此 :。
为把截距一起写入正规方程,定义:
此时 为 , 为 。课程有时仍把这个扩展参数向量写成 ;本资料用 区分,避免漏掉截距。
NumPy 的 (d,) 是一维数组,严格说既不是二维行向量,也不是二维列向量;对它做 .T 仍是 (d,)。写手算矩阵与读代码时要分别核对形状。
import numpy as np

X = np.array([[1., 2.], [3., 4.], [5., 6.]])
w = np.array([[2.], [-1.]])
b = 3.
X_b = np.c_[np.ones(len(X)), X]  # 添加截距列
theta = np.vstack([[[b]], w])
print((X @ w + b).ravel())       # [3. 5. 7.]
print(X_b.shape, theta.shape)    # (3, 3) (3, 1)
运行输出:
[3. 5. 7.]
(3, 3) (3, 1)
3. 三种误差指标
| 指标 | 中文与英文 | 单位 | 侧重点 |
|---|---|---|---|
| MSE | 均方误差(Mean Squared Error) | 目标单位的平方 | 便于优化、求导 |
| RMSE | 均方根误差(Root Mean Squared Error) | 与目标相同 | 较大的误差权重更高 |
| MAE | 平均绝对误差(Mean Absolute Error) | 与目标相同 | 直接表示平均绝对偏差 |
三者都越小越好。因为平方根在非负范围单调递增,最小化 MSE 与最小化 RMSE 得到相同最优参数;MAE 的最优参数则不一定相同。
对同一批误差,;所有误差的绝对值相等时取等号。RMSE 明显大于 MAE 提示部分误差偏大,但仍应看误差分布,不能只凭两个数定位异常样本。
手算例题 A(自编):实际值 ,预测 。
- 残差为 。
- 。
- 。
- 。
正负残差会抵消,不能用平均带符号残差代替上述误差指标。
4. 正规方程(Normal Equation)
对带截距的设计矩阵,普通最小二乘(Ordinary Least Squares, OLS)求解:
矩阵形状按顺序为:。
条件:上述“显式求逆”写法要求 满列秩(Full column rank)。完全重复或完全线性相关的列,会使 不可逆; 是必要条件,但不足以保证满秩。
这不等于“线性回归不能训练”。伪逆(Pseudoinverse)、奇异值分解(Singular Value Decomposition, SVD)等方法仍可求最小二乘解;参数可能不唯一。
LinearRegression() 通常无需手工加 1 列。它求解相同的最小二乘问题,普通稠密输入使用数值最小二乘求解器;不要把其内部实现背成“直接调用 np.linalg.inv”。
手算例题 B(自编):。
其逆为 ,因此 ,模型为 。
可选推导:从 出发,令梯度 ,得到正规方程组;只有满足可逆条件时,才进一步写成上面的逆矩阵公式。
5. 最小可运行代码
以下为自编模拟数据,只用于理解流程。训练均值基线(Mean baseline)必须使用 y_train.mean()。
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

rng = np.random.default_rng(409)
X = rng.uniform(0, 5, size=(100, 1))
y = 5 + 3 * X[:, 0] + rng.normal(0, 0.5, size=100)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=409
)
model = LinearRegression().fit(X_train, y_train)
pred = model.predict(X_test)
baseline = np.full(len(y_test), y_train.mean())  # 训练均值

print(model.intercept_, model.coef_)
print(np.sqrt(mean_squared_error(y_test, pred)))
print(mean_absolute_error(y_test, pred))
print(r2_score(y_test, pred))
print(np.sqrt(mean_squared_error(y_test, baseline)))
运行输出:
4.855537686983717 [3.04955243]
0.5461359526264463
0.44602283198394543
0.9758685739852215
3.640610722688897
代码中 y 为 (n,),所以单目标模型的 coef_ 为 (d,),intercept_ 为标量;若 y 为 (n,1),属性形状会相应不同,但模型含义一致。
给上面的模拟代码补上业务含义: 可把 X[:,0] 理解为广告投入(千元),y 理解为销售额(千元)。生成式 5+3*x+噪声 代表我们人为设定的教学关系,不是真实广告数据。100 行拆成 80 行训练和 20 行测试;模型从训练行估计截距与系数,再对测试中的每个投入金额输出一个销售额。
new_spend = np.array([[2.0], [4.0]])  # 两个投放方案,单位千元
sales_prediction = model.predict(new_spend)
print(sales_prediction.shape)        # (2,)
print(sales_prediction.round(2))      # 约为 11、17 千元附近
运行输出:
(2,)
[10.95 17.05]
两行一列表示“两个方案、同一个特征”,不是一行两个特征。模型训练在有噪声且经过划分的数据上,所以结果不要求精确等于 11、17。baseline 则对所有测试行重复同一个训练均值;与它比较能看出使用投入信息是否改善预测。
6. 如何解释权重
假设 ,价格单位为美元, 为存储容量单位数, 为使用年数。
- 在其他输入保持不变时, 增加 1,预测价格增加 20 美元。
- 在其他输入保持不变时, 增加 1,预测价格减少 5 美元。
- 截距 100 是所有输入为 0 时的预测;如果该组合不现实,截距不必有直接业务意义。
- 系数表达模型中的条件关联(Conditional association),不能直接解释为因果效应(Causal effect)。
输入单位不同,不能直接按原始系数绝对值排名重要性。若数值列已标准化,系数表示原特征增加一个训练集标准差时的预测变化,目标仍用原单位。
独热编码(One-hot encoding)中比较两个类别,可将其系数相减:例如“裂屏”系数 、“完好”系数 ,则其他条件相同下裂屏比完好低 。保留所有类别又有截距时会存在冗余编码,单个类别系数不是相对一个被删除的参照组;类别差值更有解释性。
相关特征可能分摊或扰动系数。置换重要性(Permutation importance)衡量打乱某列后性能下降,与系数的正负方向是不同问题;它也不是因果结论。
7. 决定系数(R-squared)
对目标非恒定的一组评估样本:
其中 是当前被评分那组实际目标的均值。测试集 R² 的分母使用测试集实际目标均值,这是指标定义;真实可部署的均值基线仍应使用训练集均值,两者不能混为一谈。
| 数值 | 解释 |
|---|---|
| 该批样本预测完全正确 | |
| 平方误差与预测该批目标均值相同 | |
| 平方误差比该均值参照更大 |
例题 A 中 ,,,所以 。若三条都预测 0,,。
R² 不是分类准确率,也不是“25% 的预测正确”。测试 R² 可以为负,训练集表现良好也不保证测试集表现良好。
8. 统计输出与业务结果
可选统计子页:statsmodels.OLS 常需用 sm.add_constant(X) 显式加截距。输出中的 coef 是系数,P>|t| 是检验系数为 0 的 p 值,[0.025, 0.975] 是 95% 置信区间。
p 值是在零假设及统计模型假定下,出现至少这样极端检验统计量的概率;不是“零假设为真的概率”。显示 0.000 是舍入结果。统计显著(Statistically significant)不等于效果大、预测重要或存在因果。
95% 置信区间(Confidence interval)的长期含义是:重复抽样并用同一方法构造区间,约 95% 的区间覆盖固定的真实参数。考试优先会读系数、显著性与区间,不必扩展到完整推断课程。
作业 4 进一步强调:回归指标不能替代业务利润。以手机回收为例,报价 ,只有 时成交;成交利润为 ,未成交利润为 0。
例如实际价值 、预测 、报价比例 :报价 ,成交后亏损 。即使总体 R² 较高,某一类手机的系统性高估也可能导致亏损。用验证数据选择经营策略,最后用独立测试数据报告结果;反复看同一测试集挑报价,所得“最佳利润”会有选择偏差。
9. 易错点与纸笔自测
易错点:截距列漏加;把 * 当矩阵乘法;对 (d,) 转置后误认为是列向量;把 RMSE 说成平均带符号误差;不加条件地对奇异矩阵求逆;直接比较不同单位的系数;把 R² 当准确率或利润。
先遮住答案完成以下 5 题。
- , 是什么形状?
- 所有误差绝对值都为 3,MAE、MSE、RMSE 各多少?
- 标准化后的“房龄”系数为 2000,意味着每增加一年房价增加 2000 吗?
- 测试集 ,R² 为多少?
- 两个特征列完全相同,正规方程的显式逆是否一定存在?
答案:1. (5,5)。2. 3、9、3。3. 不是,是增加一个训练集房龄标准差时,其他输入不变的预测变化。4. 。5. 不存在满列秩,不能用该显式逆;仍可用最小二乘数值方法求解。
10. 本章 cheatsheet 候选与来源
优先手写:预测式;四个关键形状;MSE/RMSE/MAE;正规方程与可逆条件;系数的“其他不变/单位”;R² 与训练均值基线区别。推导细节与统计推断留在完整笔记中。
课程来源:线性回归、正规方程推导(optional)、模型解释、OLS 与 R²(optional)、作业 4。课程材料核对日期:2026-10-19。
11 梯度下降(Gradient Descent)
复习目标:分清模型和训练算法,手算一次参数更新,比较 BGD、SGD 与 mini-batch,并读懂学习率、迭代轮数、停止条件和标准化代码。
1. 模型、损失和训练算法
这三个问题要分开回答:
| 问题 | 本章答案 |
|---|---|
| 用什么形式预测? | 线性回归模型: |
| 怎样衡量拟合不好? | 损失函数(Loss function):MSE |
| 怎样找到参数? | 正规方程或梯度下降等优化算法(Optimization algorithm) |
梯度下降不是一种回归模型。它通过反复调整参数来降低损失;同一种模型可以用不同算法训练,同一种优化算法也可以训练不同模型。
梯度(Gradient)收集损失对每个参数的偏导数,指向局部最陡上升方向,所以更新时沿负梯度方向走:
是学习率(Learning rate),决定步长; 是更新步数。
- 某个偏导数为正,该参数本步减小。
- 某个偏导数为负,该参数本步增大。
- 偏导数为零,该方向本步不动;“梯度为零必为全局最小”不是对任意损失都成立。
线性回归的 MSE 对参数是凸函数(Convex function);合适学习率下可收敛到全局最小。若设计矩阵不满列秩,最优参数可能不唯一。对非线性模型,MSE 不一定是凸函数,零梯度还可能对应鞍点等情况。
2. 线性回归 MSE 的梯度
本章用误差 ,即预测减实际;上一章残差写作 。平方损失不受符号影响,但求导时必须保持一致。
权重偏导数是“误差 × 对应特征”的平均再乘 2;截距相当于一个值恒为 1 的特征。
把截距并入参数,令 、,则:
形状核对:,梯度形状必须与参数相同。
某些教材把损失定义为 ,梯度就没有前面的 2;应先看损失定义,再套梯度,不能混用。
3. 一次 BGD 手算(自编)
两条数据:;初始 ;学习率 。
第一步:用同一组旧参数预测所有行。
| 行 | |||||
|---|---|---|---|---|---|
| 1 | 1 | 3 | 0 | −3 | −3 |
| 2 | 2 | 5 | 0 | −5 | −10 |
第二步:求梯度。
第三步:同时更新。
新预测为 ,MSE 从 降至 。
“同时”指两个梯度都依据旧的 计算。不能先更新 ,再用新 计算同一步的 梯度。
4. BGD、SGD 与 mini-batch
步(Step)是一次参数更新;轮(Epoch)是一次遍历训练数据。假设每轮恰好遍历 行,mini-batch 大小为 ,最后一批不足 也保留:
| 方法 | 一次更新用几行 | 每轮更新数 | 典型特点 |
|---|---|---|---|
| 批量梯度下降(Batch GD, BGD) | 全部 行 | 1 | 梯度稳定,每次更新成本高 |
| 随机梯度下降(Stochastic GD, SGD) | 1 行 | 单步便宜,方向有噪声 | |
| 小批量梯度下降(Mini-batch GD) | 行 | 兼顾计算效率与稳定性 |
例如 、10 轮:BGD 更新 10 次,SGD 更新 1000 次;若 ,mini-batch 更新 50 次。
课程手写 SGD 示例每轮有放回随机抽取 次,因此某行可能被重复抽到,另一些行没被抽到;这里“一轮”按 次抽取计。先打乱顺序再逐行遍历则会让每行每轮恰好出现一次。
单样本 SGD 梯度为:
BGD 是在同一参数点平均所有单行梯度;SGD 每处理一行就改变参数,因此跑完一轮通常不等于做一次 BGD。
接上例,顺序处理第 1 行再第 2 行。 第 1 行梯度为 ,更新后 。第 2 行的新误差为 ,梯度为 ,再更新得 ,不同于 BGD 的 。
5. 学习率、缩放与停止
学习率太小会收敛慢;太大可能在谷底两边震荡甚至发散。增加轮数不能修复一个持续发散的学习率。
学习率调度(Learning schedule)让步长随训练过程变化;退火(Annealing)通常指逐渐减小学习率,减少接近最优点时的跳动。SGD 固定步长时可能一直在最优点附近波动,单步损失不必单调下降。
特征缩放(Feature scaling)使不同量纲的特征更可比,改善损失面的形状,有助于 GD 更稳定、更快地优化。
StandardScaler 的均值与尺度必须从训练数据学习;在交叉验证(Cross-validation)中应置于流水线(Pipeline),在每个训练折内拟合。标准化不保证原分布变成正态分布。
两种停止条件不要混淆:
- 课程手写 BGD:可在 时停止,另设最大轮数上限。
SGDRegressor:max_iter是最大训练轮数;tol默认用于检查若干轮内损失改善是否足够,不是直接比较梯度范数。early_stopping=True时还涉及验证得分。
默认 n_iter_no_change=5 表示连续若干轮改善不足后停止;n_iter_ 是实际运行轮数,可能小于 max_iter。官方参数说明
6. 可运行的 BGD 小例子
以下完整程序对应手算例题。线性回归可以从 0 初始化;随机初始化不是这里的必要条件。
import numpy as np

X = np.array([[1.], [2.]])
y = np.array([[3.], [5.]])
X_b = np.c_[np.ones(len(X)), X]
theta = np.zeros((2, 1))          # 顺序为 b、w
eta = 0.1

for epoch in range(1000):
    error = X_b @ theta - y       # 预测减实际
    gradient = 2 / len(X) * X_b.T @ error
    theta = theta - eta * gradient
    if np.linalg.norm(gradient) < 1e-8:
        break

print(theta.ravel())              # 约为 [1. 2.]
print(np.mean((X_b @ theta - y) ** 2))
运行输出:
[1.00000007 1.99999996]
5.043127849703739e-16
这段循环如何对应前面的手算? 为便于理解,把两行数据看成两个广告方案:x 是投入,y 是销售额;数字与单位仅用于教学。开始 theta=[0,0],两行都预测 0,因此必须根据误差调整截距与斜率。
| 第一轮代码 | 实际得到什么 | 作用 |
|---|---|---|
X_b @ theta | [[0],[0]],形状 (2,1) | 对两条样本分别预测 |
error = ... - y | [[-3],[-5]] | 保留每条样本的预测误差 |
X_b.T @ error | [[-8],[-13]] | 将样本误差按每个参数的影响汇总 |
2 / len(X) * ... | 本例系数为 1,梯度仍为 [[-8],[-13]] | 对应 MSE 的梯度定义 |
theta - eta * gradient | [[0.8],[1.3]] | 同时得到新截距与新斜率 |
第二轮继续用新参数对同样两条训练样本预测,再算误差;不是每一轮新增一条数据,也不是每一轮增加一个特征。循环结束输出的是学到的参数,预测新投入值还需代入 b+w*x。
代码先计算完整 gradient,再更新完整 theta,自然实现同一步的同时更新。这里的 theta 与 y 都是二维列向量,避免 (n,1)-(n,) 意外广播成 (n,n)。
7. sklearn:SGD 与线性回归对照
SGDRegressor(loss="squared_error") 拟合线性预测函数。若要与无惩罚 OLS 对照,应显式设置 penalty=None;默认 penalty="l2" 会增加正则项(Regularization term),优化目标已有变化。作业 4 按要求使用默认构造器时保留该默认,不应偷偷改写作业设置。官方说明
以下自编数据示例可独立运行;两者应得到接近的结果,不要求有限步 SGD 的小数逐位相同。
import numpy as np
from sklearn.linear_model import LinearRegression, SGDRegressor
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(409)
X = rng.normal(size=(100, 2))
y = 5 + 3 * X[:, 0] - 2 * X[:, 1]
ols = LinearRegression().fit(X, y)
sgd = Pipeline([
    ("scale", StandardScaler()),
    ("model", SGDRegressor(
        loss="squared_error", penalty=None,
        max_iter=10000, tol=1e-8,
        eta0=0.01, random_state=409
    )),
]).fit(X, y)
print(np.max(np.abs(ols.predict(X) - sgd.predict(X))))
运行输出:
0.00033832065681593804
这里训练集对照是为了检验优化效果;实际比较泛化性能还需训练/测试拆分。OLS 在原始坐标下的系数与标准化后 SGD 的系数不能直接逐项比较,先统一特征尺度或比较预测值。
eta0 在默认 learning_rate="invscaling" 下是初始步长,后续还会衰减;显式设 learning_rate="constant" 才是恒定步长。参数值大并不自动表示模型更复杂或预测更准确。
8. 作业 4 的网格搜索如何读
SGD 搜索 max_iter 两个值、tol 两个值、eta0 两个值,共 组。5 折交叉验证需要 40 次折内训练,默认再对最佳参数完整重拟合 1 次,共 41 次。
如果流水线的模型步骤叫 sgd_reg,参数键必须写成 sgd_reg__eta0 等;双下划线连接步骤名和参数名。
作业使用 scoring="neg_root_mean_squared_error"。搜索器始终选择得分最大者,因此 优于 ,对应 RMSE 20 优于 50。若不指定 scoring,回归器默认 score 通常是 R²,不能擅自认为搜索在优化 RMSE。
SGD 调参主要解决收敛和所选目标的优化问题;若线性模型无法表达弯曲关系,继续增加轮数也不会自动让预测函数变成曲线。
9. 易错点与纸笔自测
易错点:把 GD 当模型;把梯度上升写成下降;漏掉损失定义中的 2;先更新一个参数再算同一步另一个梯度;把 epoch 当单样本更新;以为所有 MSE 都凸;以为增大 max_iter 必定改善;混淆标准化坐标与原坐标系数。
先作答,再看答案。
- 旧参数 ,梯度 ,,新参数是什么?
- 1000 行数据,batch size 为 128,mini-batch 每轮保留最后一批,有多少次更新?
- SGD 某一步的全训练集损失上升,是否足以证明程序写错?
- 两个设置均用线性预测函数,一个 OLS、一个默认
SGDRegressor,是否必定得到完全相同的最优参数? best_score_=-80表示“RMSE 为负数”吗?
答案:1. 。2. 。3. 否,单行随机梯度有噪声。4. 否;默认 SGD 有 L2,有限迭代与停止条件也影响结果。5. 否,负号是评分约定,对应平均交叉验证 RMSE 约为 80。
10. 本章 cheatsheet 候选与来源
优先手写:;;BGD/SGD/mini 的每步数据量和每轮步数;同时更新;scaling;eta0/max_iter/tol;负 RMSE 越大越好。
12 集成学习(Ensemble Learning)
复习目标:比较投票、装袋与提升,手算硬/软投票、OOB 概率和 AdaBoost 权重,并解释随机森林为何常比单棵深树稳定。Logistic Regression 和 SVM 在本章只作为“不同类型的基学习器”出现,不展开其独立章节。
1. 为什么组合模型
集成把多个基学习器(Base learner)的预测组合起来。有效的条件是:成员具有预测能力,而且错误不完全相同;数量多本身不保证优于最佳单模型。
对平方误差,在适当统计假定下,期望预测误差可分解为:
| 概念 | 中文含义 | 常见表现 |
|---|---|---|
| 偏差(Bias) | 模型的系统性近似误差 | 用直线拟合明显弯曲关系,训练和验证都不好 |
| 方差(Variance) | 换一批训练样本,模型变化有多大 | 深树对样本敏感,训练好而验证差 |
| 不可约噪声(Irreducible noise) | 给定现有特征仍无法确定的随机变化 | 无法仅靠更复杂模型消除 |
课程用噪声举例时也提到录入或测量错误;这些可通过数据清理减少,但不能据此说所有随机噪声都能清理掉。
浅树通常偏差较高、方差较低;深树通常偏差较低、方差较高。装袋主要降低方差,提升常通过逐步修正来降低偏差;这描述典型作用,不是所有数据和参数下的绝对定律。
2. 三类方法总览
| 方法 | 成员与数据 | 训练关系 | 预测组合 | 主要直觉 |
|---|---|---|---|---|
| 投票(Voting) | 常用不同类型模型,使用相同训练集 | 可独立训练 | 多数票/概率平均/回归平均 | 利用不同模型的互补性 |
| 装袋(Bagging) | 常用同类模型,各用不同自助样本 | 可并行 | 平均或投票 | 降低对单一训练样本的敏感性 |
| 提升(Boosting) | 通常逐步加入弱学习器 | 前后依赖、顺序训练 | 加权组合或逐步相加 | 新成员修正现有集成的不足 |
随机森林(Random Forest)属于装袋思路;AdaBoost、梯度提升(Gradient Boosting)和 XGBoost 属于提升。
3. 硬投票与软投票
硬投票(Hard voting)数类别票数;软投票(Soft voting)先平均各模型的类别概率,再选平均概率最大的类别。加权投票还可给不同模型不同权重。
课程型手算题:三个模型给出类别 A 的概率为 ,B 的概率为其补数。
- 三个硬预测为 A、B、B,硬投票选择 B。
- A 的平均概率为 ,软投票选择 A。
- 软投票保留了模型“有多确信”的信息;概率估计不可靠时,并不保证优于硬投票。
软投票要求所有成员能够提供类别概率。课程对 SVC 使用概率校准(Probability calibration);只提供 decision_function 得分还不等于直接具备 predict_proba。
下面代码可独立运行;它展示课程中的三类成员,不要求复习 Logistic Regression 或 SVM 的数学推导。
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.calibration import CalibratedClassifierCV
from sklearn.ensemble import VotingClassifier
from sklearn.metrics import accuracy_score

X, y = make_moons(n_samples=300, noise=0.25, random_state=409)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=409
)
vote = VotingClassifier(
    estimators=[
        ("tree", DecisionTreeClassifier(max_depth=3, random_state=409)),
        ("lr", LogisticRegression()),
        ("svm", CalibratedClassifierCV(
            SVC(), cv=3, ensemble=False  # 得分转为概率
        )),
    ],
    voting="soft",
)
vote.fit(X_train, y_train)
print(accuracy_score(y_test, vote.predict(X_test)))
运行输出:
0.8833333333333333
投票代码中的数据如何流动? make_moons 生成两群月牙形的二维点,每行一个点、两列为坐标,标签为所属类别。这是观察不同分类器如何组合的几何教学数据,并非酒店订单。训练集有 240 个点,测试集有 60 个点;三个成员都从训练数据学习,再分别为同一个测试点给出类别概率。
VotingClassifier(..., voting="soft") 在内部对每个点平均成员概率,vote.predict(X_test) 最后给出 60 个类别。因此它平均的是“同一条样本的多个模型意见”,不是把 60 个样本的概率混成一个数。
回归任务可平均成员的数值预测;例如三模型预测 ,等权平均结果为 。
4. 装袋、自助采样与 OOB
自助采样(Bootstrap sampling)从原来 行中有放回抽取;典型 bagging 每个样本包抽 次,所以包的行数仍为 ,但会有重复行,也有未出现的原始行。
粘贴法(Pasting)采用无放回采样,不能与 bootstrap 混淆。
某一固定原始样本,在一次抽取中未被选中的概率为 ,独立抽 次都未选中的概率为:
因此大样本下,每个包约含原始数据中 63.2% 的不同样本,约 36.8% 为袋外样本(Out-of-bag, OOB)。这两个百分数是期望近似,不是每一包都恰好如此;若抽取次数不同,公式也应改变。
手算题:原始数据仅有 5 行,每包抽 5 次。某行成为 OOB 的概率是 ,不是精确的 0.368;包内不同原始行的期望数量为 。
用五条订单看清“有放回”。 给原始行编号 A、B、C、D、E。某棵树可能抽到 [A,A,C,D,D]:训练包有 5 行,但只含 3 个不同订单;B、E 是这棵树的 OOB。另一棵树若抽到 [B,C,C,E,A],D 才是它的 OOB。由此可见,OOB 不是预先统一划出的某一组订单。以下抽样仅为示意,概率公式仍按随机抽取计算。
OOB 评估的正确思路:
- 固定一个训练样本 。
- 只找训练时没有抽到 的那些树。
- 用这些树的预测组合出样本 的 OOB 预测。
- 对有可用 OOB 预测的训练样本汇总评分。
所以 OOB 分数不是森林直接在全部训练样本上的普通训练分数,也不是“每棵树自己的 OOB 准确率简单平均”。树太少时,有的样本可能没有足够 OOB 预测。
OOB 可作为训练数据内部的泛化估计;它并不保证与独立测试得分完全相同,也不授权反复看最终测试集调参。
5. 随机森林
随机森林让树之间产生差异的两个主要来源:
- 样本随机性:每棵树使用不同 bootstrap 样本。
- 特征随机性:每个节点分裂时,只从随机抽取的一部分候选特征中找分裂。
不是“每棵树开始时只抽一次特征,并在整棵树中固定使用”。减少树之间的相关性,使平均后的预测通常更稳定。
| 参数/属性 | 读法 |
|---|---|
n_estimators | 森林中的树数,区别于每棵树深度 |
max_features | 每次分裂考虑的候选特征数 |
max_depth | 单棵树深度上限 |
min_samples_leaf | 叶节点最少样本数 |
bootstrap | 是否采用有放回样本包 |
oob_score=True | 请求 OOB 评估,要求 bootstrap=True |
oob_score_ | 拟合后得到的 OOB 分数 |
max_depth=None 表示没有显式深度上限,不代表任何数据都能得到纯叶;特征完全相同而标签冲突等情况仍会阻止进一步区分。
分类森林中,sklearn 先平均各树的类别概率,再选择概率最大的类别;不要将其实现绝对化为“每棵树给一张等权硬票”。回归森林平均各树的数值预测。RandomForestClassifier 官方说明
以下代码沿用第 3 节投票例子的数据拆分;只用训练数据拟合。
from sklearn.ensemble import RandomForestClassifier

forest = RandomForestClassifier(
    n_estimators=150, max_features="sqrt",
    bootstrap=True, oob_score=True, random_state=409
)
forest.fit(X_train, y_train)
print(forest.oob_score_)          # 训练数据内部评估
print(accuracy_score(y_test, forest.predict(X_test)))
运行输出:
0.9291666666666667
0.9166666666666666
作业 4 用 RandomForestRegressor 预测手机价格,搜索 2 个树数和 2 个深度,共 4 组参数,5 折为 20 次折内训练,默认再重拟合 1 次。
树可以刻画非线性与交互作用(Interaction):同样的“裂屏”对旗舰机和低价机的预测影响可以不同;只有加性原始特征的线性模型则给出固定差额。森林是否更好仍须由验证数据判断。
6. AdaBoost:两类权重
自适应提升(Adaptive Boosting, AdaBoost)顺序训练弱学习器,重点关注之前容易错的样本。先区分:
- 样本权重 :训练第 个学习器时,第 行算多重要。
- 学习器权重 :最终预测时,第 个学习器的意见算多重要。
课程采用标签 ,初始化每行权重为 。第 轮:
按课程页面的系数约定:
这里的对数是自然对数 ,不同于熵公式常用的 。
当 且 时,。预测错误时 ,未归一化权重乘 ;正确时乘 。最后必须归一化。
最终分类:
公式约定:考试按题目给定的一整套公式
课程写 ,并在餐厅例题中取 。常见二分类教材的基本版本在同样的对称权重更新式下写 ;若另外引入收缩率 ,可写为 。课程例题等价于教材基本版本;不要把两者的学习率符号数值直接一一对应,也不要把某版本的系数与另一版本的更新式拼在一起。二分类 AdaBoost 推导
此外,sklearn 的算法实现与多分类推广另有配套约定,不能只比较 learning_rate 数值就断言其每一步必定复现手算表。
手算一轮:10 行,错 3 行
初始每行权重 ,加权错误率 ,按课程取 :
| 样本 | 未归一化新权重 | 归一化后每行权重 |
|---|---|---|
| 3 条错分行 | ||
| 7 条正确行 |
总和 。错分行新权重总和为 ,正确行总和也为 。
“错分行新总权重恰好为一半”在这里由特定系数产生;按课程公式换成任意 时不必成立。一般新错分权重占比为 。
import numpy as np

weights = np.full(10, 0.1)
wrong = np.array([True] * 3 + [False] * 7)
error = weights[wrong].sum() / weights.sum()
alpha = 0.5 * np.log((1 - error) / error)  # 课程例题约定
weights *= np.where(wrong, np.exp(alpha), np.exp(-alpha))
weights /= weights.sum()                  # 归一化
print(alpha, weights[0], weights[-1])
print(weights[wrong].sum(), weights.sum()) # 0.5、1.0
运行输出:
0.4236489301936017 0.16666666666666666 0.07142857142857144
0.5 1.0
后续轮次计算的是加权错误率:错同样 3 行,若其权重不同,错误率可以不同。课程餐厅例题的三学习器约重 ;对一个投票为 的样本,最终分数约为 ,预测 。
7. 梯度提升与 XGBoost
AdaBoost 调整样本权重;梯度提升逐步添加预测函数来改善当前集成。平方损失回归中,可用当前残差训练下一棵树:
其中 拟合本轮残差。更一般的损失使用负梯度形成的伪残差(Pseudo-residual),所以不能把所有分类梯度提升都简单写成“用 0/1 标签减最终类别”。
手算小例:真实值 ,当前预测 ,新树给出残差预测 ,学习率 ,则新预测为 ,不是 ,也不是直接改为 。
XGBoost 是高效实现梯度提升的一套工具。会辨认 XGBClassifier/XGBRegressor 的任务类型即可;本章无需展开其系统优化细节。
梯度下降(GD)更新给定模型的参数;梯度提升(GB)逐步加入新学习器,两者名称相近,但不是同一算法。提升模型中学习率、树数和树复杂度需要共同调节;更多轮数不保证测试性能更好。
8. 易错点与纸笔自测
易错点:把 bagging 写成无放回;认为每个包只含 63.2% 行;把每节点抽特征写成每树只抽一次;用参与训练该行的树计算其 OOB 预测;忽略 AdaBoost 归一化;把所有“错三条”都当 30%;认为集成必胜或不会过拟合。
自测:
- 三个 A 类概率为 ,硬投票与软投票分别选什么?
- 某样本被第 1、3 棵树的 bootstrap 样本抽到,未被第 2、4 棵抽到;它的 OOB 预测用哪些树?
- AdaBoost 中,两行权重各为 0.4,其余八行各 0.025;若只错这两行,错误率是多少?
- 固定其他条件,
n_estimators=200是否表示每棵树深度 200? - 回归梯度提升当前预测 8,新树预测残差 −2,学习率 0.2,新预测多少?
答案:1. 硬投票 A;软投票 A 均值约 0.343,因此 B。2. 第 2、4 棵。3. 0.8,尽管仅错 20% 的行。4. 否,表示 200 棵树。5. 。
9. 本章 cheatsheet 候选与来源
优先手写:Voting/Bagging/Boosting 对照;硬票与平均概率;bootstrap 有放回;OOB 公式及按样本筛树;RF 每节点随机候选特征;AdaBoost 两类权重、课程 例子与归一化;GB 拟合残差、乘学习率后相加。
13|综合自测
以下为根据课程内容自编的练习,不是真题或考试预测。共 48 道判断、12 道选择、12 道简答、12 道代码/计算综合题,共 84 题。先做题,再打开答案文件;判断为错时,尝试把原句改成正确表述。
一、判断题
第 1 章|概论
- T01:目标存成整数 0/1,因此任务一定是回归。
- T02:部署后持续监控数据和模型表现,属于机器学习工作流。
- T03:只要训练准确率达到 100%,便能确认未来预测可靠。
- T04:同一预测模型连接不同业务行动,错误成本可能不同。
第 2 章|Python
- T05:
range(1, 4)包含 1、2、3、4。 - T06:
set()可以去重,普通集合本身也可以被修改。 - T07:
values.sort()返回一个新的已排序列表,原列表不变。 - T08:函数执行了
print(3),就必然向调用者返回整数 3。
第 3 章|NumPy
- T09:
(5,)和(1, 5)是相同形状。 - T10:对形状
(3,4,5)求sum(axis=1),默认结果形状为(3,5)。 - T11:两个数组元素总数相同,就一定能直接广播相加。
- T12:修改 NumPy 基本切片视图,可能修改原数组。
第 4 章|Pandas
- T13:
.loc[]根据标签选择,整数标签也不自动代表当前位置。 - T14:
df['x']与df[['x']]的返回对象维度总是相同。 - T15:
groupby().max()的各列最大值可能来自不同原始行。 - T16:分组汇总时,某列有缺失值,
groupby(...)[列].count()与groupby(...).size()仍必然相同。
第 5 章|绘图
- T17:一个 Figure 可以包含多个 Axes。
- T18:箱线图箱体里的横线通常表示均值。
- T19:默认箱线图异常边界按中位数 ± 1.5IQR 计算。
- T20:散点图显示线性相关很弱,就能断言两个变量没有任何关系。
第 6 章|基线与 Kaggle
- T21:人工制定的简单规则也可以作为模型比较的基线。
- T22:sample_submission 中的预测列应当视为测试集真实标签。
- T23:为使测试数据没有缺失值,可以直接删行后再提交剩余预测。
- T24:反复根据公开排行榜修改方案,可能对公开评分样本过拟合。
第 7 章|预处理
- T25:标准化后,任何输入分布都会变成正态分布。
- T26:用训练均值和标准差转换测试集后,测试均值必然为 0。
- T27:独热编码避免强加类别大小关系,但可能明显增加列数。
- T28:所有被异常值规则标记的观测都是错误数据,应该删除。
第 8 章|决策树
- T29:纯节点的熵与 Gini 都为 0。
- T30:计算分裂后熵时,应直接对所有子节点熵取简单平均,不用看样本数。
- T31:设置
criterion='entropy',就把 sklearn 的二叉树完整变成了经典 ID3。 - T32:减小
max_depth一般会加强复杂度约束,但不保证测试准确率一定上升。
第 9 章|评估与管道
- T33:精确率的分母是所有实际正类数量。
- T34:测试集没参与
.fit(),所以用它挑超参数不影响最终评估独立性。 - T35:10 组候选参数、5 折交叉验证、默认重新拟合,总计需要 51 次模型拟合。
- T36:把全数据预先标准化后再对模型做 CV,与把标准化放在 CV 管道里完全等价。
第 10 章|线性回归
- T37:不同量纲特征中,原始系数绝对值最大的特征必然最重要。
- T38:对同一数据与模型族,最小化 MSE 与 RMSE 得到相同最小化解。
- T39:模型截距为负,说明模型在所有真实样本上必然给出负预测。
- T40:测试集上的 R-squared 不可能小于 0。
第 11 章|梯度下降
- T41:梯度下降是一种寻找模型参数的训练算法。
- T42:任何可微函数在梯度为零处都达到全局最小值。
- T43:SGD 每次更新后的全训练集损失都必然下降。
- T44:只要训练达到了设定的最大轮数,就已经证明收敛。
第 12 章|集成学习
- T45:软投票利用概率,因此总是优于硬投票和所有单个模型。
- T46:OOB 是预先从全部训练数据固定留出的同一份 37% 样本。
- T47:随机森林除随机抽样训练行外,还在每次分裂考虑随机部分特征。
- T48:AdaBoost 与 Gradient Boosting 的共同机制都是提高错分行权重,其他过程没有区别。
二、简答题
- S01|概论:预测预订取消时,怎样从“模型准确”走到“业务有价值”?
- S02|Python:解释列表、元组、字典和集合的不同,并分别给一个适合用途。
- S03|NumPy:为什么一个长度为 3 的数组不能直接作为
(3,4,5)数组的门店系数?如何修正? - S04|Pandas:Marriott 数据只包含等级发生变化的酒店。为什么不能用这张表的总行数作为“全球升级比例”的分母?
- S05|绘图:如何区分条形图、直方图、箱线图和散点图的用途?
- S06|基线:为什么在训练复杂模型前应有规则/多数类基线?基线没被超过时怎么办?
- S07|预处理:为什么填补与标准化必须从训练数据学习?CV 时应怎样做?
- S08|决策树:解释
max_depth与min_samples_leaf的区别,为什么两者不能互相替代? - S09|评估:如何区分训练、验证、测试,为什么 CV 后还要重新拟合最终模型?
- S10|回归:线性系数、不纯度重要性、置换重要性各自能说明什么?
- S11|GD:为什么 SGD 和正规方程可能得到很接近的预测?哪些条件可能导致不同?
- S12|集成:比较 Voting、Bagging 和 Boosting,并解释为什么集成不保证总能获胜。
三、代码与计算综合题
P01|识别流程错误
X_scaled = scaler.fit_transform(X_all)  # 先用全数据缩放
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y_all)
for depth in [2, 4, 6, 10]:
    model = train_tree(depth, X_train, y_train)
    scores[depth] = accuracy_score(y_test, model.predict(X_test))
best_depth = max(scores, key=scores.get)
指出两个评估方法上的问题,并写出正确流程的文字逻辑。这里 train_tree 是表示训练步骤的伪函数,不要求补其具体 API。
P02|函数与循环输出
def label(x):
    if x >= 3:
        return 1
    return 0

result = [label(x) for x in range(1, 5)]
result 是什么?如果删掉所有 return,改用 print,result 会发生什么变化?
P03|数组形状
已知 sales.shape == (3,4,5),轴依次为门店、周、产品。写出以下结果的形状和业务含义:
a = sales[:, 1, :]
b = sales.sum(axis=(0, 1))
c = sales[1:2].sum(axis=2, keepdims=True)
P04|从业务问题写 Pandas
df 含 brand、country、price,一行一个酒店。写出逻辑或代码:仅选 China,计算各品牌平均 price,按均价降序取前三名。再说明结果是不是“每个品牌中最贵的酒店”。
P05|子图与图型
fig, ax = plt.subplots(2, 3)
ax[1, 2].plot(x, y)
共有几幅绘图区?数据画在哪一个?若要展示房价的单变量分布,应优先用哪种图型?若要看收入与房价关系,又应用什么?
P06|规则预测
pred = ((days > 90) & (deposit == 'NoDeposit')).astype(int)
对三行 (30, NoDeposit)、(120, NoDeposit)、(150, NonRefundable) 分别预测什么?规则用了什么信息?不能据此得出什么因果结论?
P07|缩放与编码
训练均值 μ=10、标准差 σ=2,新样本 x=14。按训练规则标准化后是多少?为什么不能在这个单个新样本上重新估计均值和标准差?如果独热编码时出现新类别,应该怎样处理并说明限制?
P08|信息增益
父节点 4 正、4 负。分裂 A 得到两个等大节点,类别计数分别为 (3,1)、(1,3);分裂 B 得到 (4,0)、(0,4)。计算两者的信息增益,选择更优分裂;并说明结果是否保证全树全局最优。
P09|指标、成本与训练次数
TP=40、FP=10、FN=20、TN=130,正类为取消。计算 Accuracy、Precision、Recall、F1,以及 FP=400 美元、FN=150 美元时的错误成本。
另有 2 种填补策略、2 种准则、3 种深度,做 5 折 CV,默认重新拟合。共有几组参数、几次拟合?
P10|回归误差与 R²
真实值 [10,20,30],预测 [12,17,31]。计算 MSE、RMSE、MAE、R²。说明这些误差中哪些与目标单位相同;能否仅凭 R² 判断业务盈利?
P11|梯度与轮数
,初始 w=0,η=0.1。计算一次梯度、更新后的 w 和损失。
100 个训练样本训练 10 轮:BGD 有多少次更新?每轮逐样本 SGD 呢?把学习率增大到任意值,能否保证更快收敛?
P12|投票与 OOB
在 A/B 二分类中,三个分类器对 A 的概率为 [0.9,0.45,0.45]。等权硬投票、软投票分别选什么?从 n 个样本有放回抽 n 次,一行未被抽到的概率公式是什么?这能否解释为同一行从未参与森林训练?
四、单项选择题
每题只有一个最合适的选项,按课程顺序排列。
M01|任务类型
输入用户过去一个月的使用记录,预测其下月是否取消订阅,最合适的任务是:
- A. 无监督聚类
- B. 监督分类
- C. 监督回归,因为结果用 0/1 存储
- D. 强化学习,因为取消订阅会损失收入
M02|列表与返回值
执行 a = [3, 1, 2]; b = a.sort() 后,哪项正确?
- A. a 保持原样,b 为
[1, 2, 3] - B. a 和 b 都为
[1, 2, 3] - C. a 为
[1, 2, 3],b 为None - D. 因为列表不可变而报错
M03|广播
sales.shape == (3, 4, 5),cost.shape == (3,),cost 依次对应三个门店。哪一种写法将每家门店的系数应用到其全部周和产品?
- A.
sales * cost - B.
sales * cost.reshape(1, 1, 3) - C.
sales * cost.reshape(3, 1, 1) - D.
sales @ cost
M04|标签索引
s = pd.Series([10, 20, 30], index=[2, 4, 6])。哪项正确?
- A.
s.loc[2]为 30 - B.
s.iloc[2]为 30 - C.
s.iloc[4]为 20 - D.
s.loc[4:6]不包含标签 6
M05|箱线图
已知 Q1=20、Q3=40,使用 1.5IQR 规则。哪个观测超过围栏?
- A. 0
- B. 20
- C. 60
- D. 80
M06|回归基线
已有训练集与锁定的测试集。构造预测所有手机同一价格的均值基线,应使用:
- A. 测试集真实价格的均值
- B. 训练集与测试集价格的合并均值
- C. 训练集真实价格的均值
- D. 使测试 RMSE 最低的任意常数,即使要查看测试标签
M07|预处理顺序
在开发数据上做 5 折 CV,哪种流程最符合独立验证要求?
- A. 先在全部开发数据 fit 填补器与缩放器,再对模型做 CV
- B. 每折只在该折训练部分 fit 整条 Pipeline,再预测该折验证部分
- C. 每折训练部分、验证部分各自 fit 一个缩放器
- D. 先在最终测试集 fit 缩放器,使测试分布更准确
M08|树的复杂度
一棵训练准确率很高、验证准确率较低的树,哪项通常会加强复杂度约束?
- A. 提高
max_depth - B. 降低
min_samples_leaf - C. 增加允许的最大叶节点数
- D. 提高
min_samples_leaf
M09|负损失分数
网格搜索使用 scoring='neg_root_mean_squared_error'。四个候选平均分为 −8、−12、−5、−10,应选:
- A. −12,因为绝对值最大
- B. −10,因为居中
- C. −5,因为分数最大,对应 RMSE 最小
- D. 必须选正分,负分说明代码出错
M10|R²
某模型在测试集上的 R²=−0.2,最准确的解释是:
- A. 其预测准确率是 −20%
- B. 在该测试集上,其平方误差和比预测该测试集真实值均值更大
- C. 所有线性系数都为负
- D. 必然发生代码错误,因为 R² 最小只能为 0
M11|梯度下降
J(w)=(w−3)²,w=0、学习率 η=0.1。一次梯度下降后的 w 是:
- A. −0.6
- B. 0.3
- C. 0.6
- D. 3
M12|随机森林与 OOB
对于某一训练样本,其袋外预测(OOB prediction)应聚合:
- A. 全部树,因为它属于训练集
- B. 只聚合训练时没有抽到该样本的树
- C. 只聚合训练时抽到该样本的树
- D. 只取训练准确率最高的一棵树
题目完成后再打开答案与解释。
14|综合自测答案
先独立作答,再核对。数值例题允许合理四舍五入;简答题重点在条件和理由。
一、判断题答案与理由
| 编号 | 答案 | 关键理由/正确表述 |
|---|---|---|
| T01 | 错 | 类型由目标含义决定;0/1 可以编码类别 |
| T02 | 对 | 数据分布和业务关系可能变化,需要持续监控与更新 |
| T03 | 错 | 可能记住训练噪声,需独立验证泛化 |
| T04 | 对 | 超售与发送短信的错误后果不同 |
| T05 | 错 | 不包含右端 4,结果为 1、2、3 |
| T06 | 对 | 普通 set 可变且去重,与 frozenset 不同 |
| T07 | 错 | 原地修改并返回 None;sorted() 返回新列表 |
| T08 | 错 | 显示与返回不同;未显式返回则返回 None |
| T09 | 错 | 前者一维,后者二维 |
| T10 | 对 | 消去长度 4 的轴,剩门店×产品 |
| T11 | 错 | 广播比较对应维长度,不看总元素数 |
| T12 | 对 | 基本切片通常共享数据;可用 copy() 隔离 |
| T13 | 对 | 标签和位置是不同概念 |
| T14 | 错 | 前者通常 Series,后者 DataFrame |
| T15 | 对 | 聚合各列分别计算,不保证对应一条原始行 |
| T16 | 错 | 对指定列的 count 排除缺失;GroupBy 的 size 计组内总行数 |
| T17 | 对 | Figure 是容器,Axes 是各绘图区 |
| T18 | 错 | 中线是中位数 |
| T19 | 错 | 边界为 Q1−1.5IQR 与 Q3+1.5IQR |
| T20 | 错 | 可能存在非线性关系;且相关不证明因果 |
| T21 | 对 | 基线可以来自简单业务规则 |
| T22 | 错 | 它说明格式,其值不能当作公开真实标签 |
| T23 | 错 | 通常要求每个指定 ID 一条预测,应合理填补 |
| T24 | 对 | 公开样本反复参与选择,可能高估未来表现 |
| T25 | 错 | 标准化调整位置和尺度,不保证正态 |
| T26 | 错 | 使用训练统计量,测试分布不必相同 |
| T27 | 对 | 不强加顺序,但高基数可能带来很多列 |
| T28 | 错 | 极端但真实的观测可能有业务价值 |
| T29 | 对 | 所有样本同类,不确定性为零 |
| T30 | 错 | 应按子节点样本占比加权 |
| T31 | 错 | 只换不纯度准则,仍是相应的二叉树实现 |
| T32 | 对 | 可能缓解过拟合,也可能过强而欠拟合 |
| T33 | 错 | Precision 分母是预测正类 TP+FP |
| T34 | 错 | 测试分数参与选择也属于信息使用 |
| T35 | 对 | 10×5+1=51,最后一次 refit |
| T36 | 错 | 全数据缩放让留出折信息进入处理参数 |
| T37 | 错 | 单位影响系数大小,相关特征也影响解释 |
| T38 | 对 | 平方根在非负范围单调,最小化解相同 |
| T39 | 错 | 截距只对应所有特征为零时的预测 |
| T40 | 错 | 模型可比均值参照更差,R² 可为负 |
| T41 | 对 | 它优化参数,不是独立预测模型 |
| T42 | 错 | 非凸时可能是极大点或鞍点;还要看目标性质 |
| T43 | 错 | 单样本方向有噪声,全样本损失可能暂时上升 |
| T44 | 错 | 轮数是计算上限,不能代替收敛诊断 |
| T45 | 错 | 概率质量、相关错误和弱模型都可能拖累结果 |
| T46 | 错 | 不同树有不同未入袋行,不是统一固定测试集 |
| T47 | 对 | 两层随机性帮助降低树之间相关性 |
| T48 | 错 | AdaBoost 调权重;GB 在平方误差时拟合残差,更一般为负梯度 |
二、简答题参考要点
S01
先确定正类和预测时间点,再明确预测结果触发的行动。列出 FP 与 FN 后果和成本,与当前规则比较;在未参与选择的数据上评估,再判断提升是否值得执行成本。不能从较高准确率直接跳到“可以超售”。
S02
列表:可变有序序列,可保存待处理订单。元组:固定组合,可表达形状。字典:按唯一键映射值,可记录客户属性,保持插入顺序。集合:可变无序去重,可统计不同类别或做成员判断。索引、重复值和可变性要分开说明。
S03
广播从右比较,最右的 5 与 3 不匹配。把门店系数改为 (3,1,1),使其与门店轴对齐,并可沿周和产品轴扩展。广播由形状决定,不根据变量名字猜含义。
S04
题目问全球酒店,分母必须覆盖全球酒店总体。变更表只是被筛选出的子集,用其行数得到的是“变更酒店内部升级比例”,与“全球酒店升级比例”不是同一个指标。
S05
条形图比较类别汇总量,直方图看连续变量分布,箱线图概括中位数/四分位范围/异常值,散点图看两个数值变量关系。选择依据是问题,不是只根据图是否好看;图表不能自动证明因果。
S06
基线提供简单可执行的参照,避免只报告一个孤立模型分数。未超过时先检查数据、划分、编码、指标和训练,再判断复杂模型是否必要;不能仅因为用了 ML 就认为比规则好。
S07
填补与缩放参数会包含样本信息,使用留出数据估计会使评估偏乐观。每个 CV 训练折分别 fit 全部预处理,在其验证折只 transform;选定后再在全部开发数据 fit,最终测试只应用已有规则。
S08
深度限制控制每条路径问多少问题,叶样本限制控制最终每个预测依赖多少训练记录。浅树仍可能隔离单行;叶样本数够大也不必树很浅。两者约束不同,需在验证中共同权衡。
S09
训练学参数,验证选方法/设置,测试评估已经确定的方案。CV 各轮只使用开发数据的一部分来拟合;选定设置后重新利用全部开发样本得到最终模型,而非任意使用一折模型。
S10
系数给出模型内的方向和单位变化效应,原始大小受量纲影响;不纯度重要性衡量树分裂累计贡献,没有方向;置换重要性衡量打乱列后表现下降,可用于多类模型。三者都依赖模型和数据,不自动代表因果。
S11
它们可以优化同一线性模型的平方误差目标。相同输入和损失、无正则且充分收敛时,预测应接近。学习率、停止条件、缩放、随机性、默认正则化和秩不足可能造成差异。
S12
Voting 合并多个模型预测;Bagging 用随机样本并行训练再组合,常降方差;Boosting 顺序添加修正,常降低偏差。若成员错误高度相关、概率不可靠、个体模型过弱或训练过拟合,集成未必改善测试表现。
三、综合题参考答案
P01
第一处:先对全数据 fit_transform,再划分,测试信息已进入训练使用的缩放规则。第二处:用最终测试集比较深度并选择获胜者,测试集实际变成验证集。
正确流程:先锁定测试集 → 在开发数据中划验证/做 CV → 每个训练折拟合缩放和树 → 用验证分数选深度 → 全部开发数据重新拟合完整方案 → 测试一次。树通常不需要缩放;若使用也应放进该流程。
P02
result 为 [0,0,1,1]。range(1,5) 包含 1–4。若函数只打印、没有 return,则列表收集的是 [None,None,None,None],打印结果与返回结果不同。
P03
- a:
(3,5),全部门店在第 2 周的各产品销量。 - b:
(5,),每个产品跨全部门店与周的总销量。 - c:
(1,4,1),第 2 家店每周的产品总销量,门店轴和被聚合产品轴均保留。
P04
result = (df.loc[df['country'] == 'China']
          .groupby('brand')['price'].mean()
          .sort_values(ascending=False).head(3))
每个输出值是该品牌在中国样本的平均价格;不是品牌中最贵的某个酒店,也不自动推广到数据没有覆盖的酒店。
P05
共有 6 个 Axes,ax[1,2] 是第 2 行第 3 列。房价单变量分布优先看直方图,箱线图可补充分位信息;收入与房价关系用散点图。任意行号连线不能当作时间变化。
P06
输出 [0,1,0]。规则用预订提前时间与押金类型组合预测,不需要在预测时知道真实取消标签。不能推出“强制缩短提前时间就一定减少取消”,规则建立在关联而非因果识别上。
P07
。单样本重新拟合会使自身均值为 14,标准差无法提供同样的训练尺度,也与已训练模型输入意义不一致。新类别应按训练编码规则处理,可用 handle_unknown='ignore' 令该组全零;这只保证格式兼容,不保证预测质量。
P08
父节点熵为 1;A 的两子节点熵均约 0.811,因等大而加权熵约 0.811,IG≈0.189。B 的子节点熵都为 0,IG=1,因此当前应选 B。贪心当前最优不一般性保证全树全局最优;本例分裂后已经纯净。
P09
总数 200;Accuracy=170/200=0.85;Precision=40/50=0.8;Recall=40/60≈0.667;F1=80/110≈0.727;成本=10×400+20×150=7000 美元。
参数组合 2×2×3=12,CV 拟合 12×5=60 次,加默认 refit 1 次,共 61 次。best_score_ 是获胜组合平均 CV 分数,不是最后独立测试分数。
P10
平方误差和=4+9+1=14。MSE=14/3≈4.667,RMSE≈2.160,MAE=6/3=2。真实值均值 20,总离差平方和=100+0+100=200,所以 R²=1−14/200=0.93。RMSE、MAE 与目标同单位,MSE 是平方单位,R² 无单位。盈利还依赖行动、误差方向和成本。
P11
梯度 ,新 w=0.6,新损失 。BGD 10 次更新,逐样本 SGD 1000 次。学习率任意增大可能使算法振荡或发散;“步大”不等于“更快收敛”。
P12
硬投票选 B,两票;软投票平均 A 概率为 0.6,选 A。未入袋概率为 ,n 大时约 0.368。一行对某棵树是 OOB,不表示它没有被其他树用于训练;其 OOB 预测只聚合排除它的那些树。
四、单项选择题答案
| 编号 | 答案 | 解释 |
|---|---|---|
| M01 | B | 有历史标签且预测取消/不取消,是监督分类;数字编码不改变目标含义 |
| M02 | C | list.sort() 原地排序,返回 None;sorted(a) 才返回新列表 |
| M03 | C | 从右比较形状,(3,1,1) 与门店轴对齐,其他两轴可广播 |
| M04 | B | iloc 第 3 个位置是 30;loc[2] 为 10;iloc[4] 越界;loc 标签切片含右端 |
| M05 | D | IQR=20,下围栏 −10,上围栏 70,80 在围栏之外 |
| M06 | C | 可部署的基线只能从训练目标学习常数;测试标签留作评估 |
| M07 | B | 填补、缩放、编码和模型必须作为整体在每个训练折内拟合 |
| M08 | D | 较大的叶最小样本数减少对少量记录的拟合;是否改善验证表现仍需检查 |
| M09 | C | sklearn 搜索最大化 scorer;−5 > −8 > −10 > −12,对应 RMSE=5 最低 |
| M10 | B | R²=1−SSE/SST;负值意味着 SSE>SST,不是负准确率 |
| M11 | C | 梯度为 2(0−3)=−6,新 w=0−0.1×(−6)=0.6 |
| M12 | B | 每行只能用未见过它的树产生 OOB 预测,不同样本对应的树集合不同 |
M10 的测试均值只是 R² 定义中的评价参照;不能因此在部署时使用未知测试标签建立基线。
错题记录模板
| 题号 | 我原来的理解 | 正确规则与条件 | 回看章节 | 再做结果 |
|---|---|---|---|---|
| 例:M03 | 元素数相同就能广播 | 从右对齐,每维相同或有 1;门店系数需 (3,1,1) | 03 | 待复做 |
15|A4 双面手写提纲
这是按课程顺序压缩的手写选材稿,供复习后抄写。Markdown 本身没有被排成两张印刷页面;实际容量需按自己的笔迹试写。考试只允许本人手写的一张 A4 双面纸。
建议正面放第 1–7 章,背面放第 8–12 章;每面两栏。先抄自己易错的性质、公式与方法比较,再决定是否保留短代码。
如何分配纸面
| 区域 | 内容 | 首先保留 |
|---|---|---|
| 正面左栏 | 1–3 概览、Python、NumPy | 切片、返回值、shape/axis、广播 |
| 正面右栏 | 4–7 Pandas、绘图、基线、预处理 | loc/iloc、分母、箱线图围栏、训练统计量 |
| 背面左栏 | 8–9 决策树、评估 | 不纯度、混淆矩阵、成本、CV/Pipeline |
| 背面右栏 | 10–12 回归、GD、集成 | 误差、更新式、算法对比、OOB |
下面是候选内容,不保证逐字全部抄入后仍清晰。先试写最密集的“评估”一栏;空间不足时,先删熟悉的文字解释和完整代码,保留易错公式、条件及你自己的错题提示。最后留少量空位补漏。
正面|概念、工具、基线、预处理
1.概论
特征(Feature)是预测时已知输入,标签(Label)是目标。分类(Classification)预测类别,回归(Regression)预测数值;目标存成 0/1 不代表回归。监督有标签;无监督找结构;强化从奖励学策略。
流程:业务目标 → EDA → 清洗/特征工程 → 训练/验证 → 测试 → 部署监控。训练好≠泛化好;预测关联≠因果;指标提升≠盈利提升。
2.Python
List:有序、可变、可重复;Tuple:有序、不可重新赋元素;Dict:键唯一、可变、插入有序;Set:去重、可变、无位置顺序。{} 是字典,空集合 set()。
切片 [start:stop:step] 不含 stop;range 同理。sort() 原地改、返回 None;sorted() 返回新列表。return 返回,print 显示。break 退出循环,continue 跳过本轮。
3.NumPy
shape 各轴长度;ndim 轴数;size 各长度乘积。(n,)≠(1,n)≠(n,1);整数索引消轴,切片留轴。基本切片是视图,隔离修改用 .copy()。
例:sales[1,:,2] 固定校园店与冷萃,得到四周销量 (4,);sales[:,1,:] 固定第 2 周,得到门店×产品 (3,5)。切片后按新对象重新认轴,详见 03 索引场景说明。
sum(axis=k) 消去 k 轴;keepdims=True 保留该轴为 1。max 值,argmax 位置。广播从右对齐:每维相同或有 1。* 逐元素;@ 矩阵乘法。
# sales:门店×周×产品,(3,4,5)
sales.sum(axis=(1, 2))  # 每店,(3,)
sales.sum(axis=(0, 1))  # 每产品,(5,)
sales * price  # price:(5,)
sales * cost.reshape(3, 1, 1)  # 每店系数
4.Pandas
Series 一维,DataFrame 二维。df['x'] 一维,df[['x']] 二维;loc 标签切片通常含两端,iloc 位置切片不含右端。筛选用带括号的 & | ~。
某列的 count() 计非缺失数,groupby(...).size() 计组内行数;df.size 则是单元格数。nunique 不同值数;value_counts(normalize=True) 默认除以非缺失数;idxmax 最大值标签。groupby().max() 各列可能不是同一原始行。先确认总体与分母。
df.loc[(df.x > 0) & (df.g == 'A'), ['x']]
df.groupby('g')['x'].mean().sort_values()
df.loc[mask, 'pred'] = 1  # 条件赋值
df.to_csv('submission.csv', index=False)
5.绘图
Figure 容器,Axes 绘图区,Axis 坐标轴。折线:顺序趋势;条形:类别比较;直方:分布;箱线:中位数/分位/异常;散点:关系。
;边界 、;箱内线是中位数。须线到边界内实际观测,图上异常不等于已删行。相关为 0 不排除非线性关系。
6.规则基线
Kaggle train 有标签,test 待预测,sample_submission 仅格式。多数类/简单规则可作基线。提交须每个 ID 一条、列顺序含义一致,不删预测行。排行榜反复挑方案也可能过拟合。
7.预处理
缺失:少量可考虑删行;重要列要谨慎删;均值受极值影响,中位数稳健;众数适合类别;前后填充要求合理顺序。
,|z|≥3 只是潜在异常规则。标准化不保证正态/[0,1],测试不必均值 0;只从训练 fit,测试 transform。树一般不需缩放,GD 很敏感。
Ordinal 可引入虚假顺序;One-hot 不强加大小但可能列多。OneHotEncoder(handle_unknown='ignore') 把未知类别对应编码块设为全零,只保证格式兼容。泄漏:全表预处理、使用事后字段、看 test 选设置。
背面|树、评估、回归、优化、集成
8.决策树
,纯节点 0;二分类最大 1。,二分类最大 0.5。,选当前最大增益;贪心不保证全局最佳。
ID3≠仅设置 entropy 的 sklearn 二叉树。数值阈值可尝试相邻不同值中点。减 depth/增 min leaf/增 min split 通常更约束;浅树仍可隔离单行。深度 d 最多 叶。相同 X 冲突 y 不可能全部分开。
9.评估与完整管道
先定义正类。sklearn 标签 [0,1] 时 CM=[[TN,FP],[FN,TP]]。
P 看预测正中有多少真,R 看实际正抓住多少。;Lakeside:取消=1,。F1 不等于最低成本。不平衡时高 Acc 可漏掉全部正类。
Train 学参数,Validation 选方案,Test 最终评估;CV 的 test_score 是验证折。K 折后按选定设置用全部开发数据重新拟合。C 组合、K 折、默认 refit:拟合 CK+1 次。负 RMSE 越大越好,−20 优于 −30。
数值:填补→缩放 ┐
类别:填补→编码 ┴→模型→GridSearchCV
每折内部 fit;测试只用已有规则预测
best_params_ 设置,best_score_ 最佳 CV 均分,best_estimator_ 最佳重拟合模型。管道参数 step__parameter。
重要性:加权不纯度下降累计后归一;无方向、不因果、零≠现实无关;独热贡献合回原特征。置换:固定模型打乱一列,表现下降越大越依赖该列。
10.线性回归
;系数:其他变量不变,输入增 1 单位的预测改变量。原始系数受量纲影响;截距对应全零,不代表因果或全部遗漏因素。
RMSE≥MAE;MSE/RMSE 同最优解。RMSE、MAE 同 y 单位;R² 无单位、可负。预测均值基线用训练均值;R² 的 SST 用当前评价 y 的均值。
,,逆需列满秩。LinearRegression 自动截距;无树深度式调参≠没有待学习参数。
11.梯度下降
;MSE 梯度 。先旧参数算全部梯度,再统一更新;梯度正则参数减,梯度负则参数增。
BGD 每步全样本、每轮 1 更新;SGD 每步 1 行、每轮约 n 更新;Mini-batch 每步 b 行、每轮约 ceil(n/b)。SGD 损失不必每步降。学习率大可发散,小可太慢;轮数上限不证明收敛。
GD 是训练算法;线性 MSE 凸,零梯度为全局最小,但解不必唯一;一般函数零梯度不保证最小。SGD 与 OLS 比较需相同目标、正则与充分收敛;SGDRegressor 默认 L2,要比较无正则目标需 penalty=None。
12.集成学习
Voting:组合预测;Bagging:随机样本并行训练,常降方差;Boosting:顺序修正,常降偏差。错误相似则集成收益小,不保证超越最优单模型。
Hard 多数票;Soft 平均概率。A/B 二分类等权投票,A 概率 [.9,.45,.45]:Hard B,Soft A。Bootstrap 有放回,Pasting 无放回。抽 n 次时 OOB 概率 (n 足够大),不同树 OOB 不同。
RF:样本抽样+每次分裂随机候选特征。树数量≠树深度。AdaBoost:错分样本相对权重↑,按学习器表现加权投票;GB:平方误差拟合残差,一般损失拟合负梯度;XGBoost 属梯度提升家族。
有余量再抄:Optional
阈值↑:预测正集合缩小,Recall 不升,Precision 通常升但不保证。,。ROC 左上好,AUC 随机约 .5、完美 1;阈值选择用验证数据。
手写前最后核对:分类正类、矩阵行列、误差单位、训练/测试均值区别、CV 中预处理的位置。Optional 公式细节和 AdaBoost 的学习率约定见对应章节,空间有限时不优先抄长推导。
16|勘误、范围边界与来源
课程决定复习范围;公式与软件行为按其适用条件理解。本文件记录容易误记的表述,不据此推测老师的题目或评分方式。课程资料读取日期:2026-10-19。
1. 容易误记的概念
| 主题 | 应掌握的准确表述 | 复习位置 |
|---|---|---|
| 字典(Dictionary) | 现代 Python 的 dict 保持插入顺序;键仍用于查找,不等于列表的位置索引 | 02 |
| 集合(Set) | 普通 set 可变,元素唯一,无位置索引;不可变版本是 frozenset | 02 |
| 数组切片(Array slicing) | NumPy 基本切片共享数据;布尔/整数数组等高级索引通常产生副本。不要把所有索引都当视图 | 03 |
| 分组最大值(Group maximum) | 每列独立聚合,结果可能不对应任何一条原始记录 | 04 |
| 箱线图(Box plot) | 常用围栏为 Q1−1.5IQR、Q3+1.5IQR,不是中位数±1.5IQR;须线到围栏内最远实际观测 | 05 |
| 标准化(Standardization) | 减训练均值、除训练标准差,不会保证正态分布,也不是压到 [0,1] | 07 |
| 缺失填补(Imputation) | 默认 SimpleImputer() 用均值;字符串类别须显式指定合适策略,如 most_frequent | 07、09 |
| 测试集预处理(Test transformation) | 使用训练时学到的填补/缩放规则,不能各自重新 fit 后当作同一特征尺度 | 07、09 |
| 树的纯叶(Pure leaf) | 不限制深度也不保证训练准确率 100%;相同特征但冲突标签无法完全分开 | 08 |
| 交叉验证(Cross-validation) | 提供验证估计以选择方案;本身不会自动改变模型复杂度或消除过拟合 | 09 |
| 精确率与阈值(Precision and threshold) | 固定分数时提高阈值使预测正集合缩小,召回率不增加;精确率不保证逐点单调增加 | 09 |
| 特征重要性(Feature importance) | 依赖当前模型、数据和度量;不是因果效应,不纯度重要性本身也不给方向 | 09 |
| 正规方程(Normal equation) | 显式逆公式要求设计矩阵列满秩;实际数值实现可用稳定的最小二乘求解,不必直接求逆 | 10 |
| 决定系数(R-squared) | 可为负,不是“准确率”;其 SST 使用当前评价集真实 y 的均值 | 10 |
| 零梯度(Zero gradient) | 一般目标可能有极大值或鞍点;线性回归的平方误差是凸目标,零梯度点为全局最小点 | 11 |
| SGD 的默认目标 | SGDRegressor 默认带 L2;要与无正则普通最小二乘比较同一目标,应明确 penalty=None | 11 |
| 随机森林分类预测 | sklearn 聚合各树类别概率;不要把其实现一概写成“每树先硬分类,再多数投票” | 12 |
| 袋外数据(OOB) | 相对于每棵树定义;某行的 OOB 预测只聚合没有用该行训练的树 | 12 |
上述软件行为可核对:Python 数据结构、NumPy 索引、NumPy 广播、Matplotlib 箱线图、StandardScaler、SimpleImputer。
评估与模型细节可核对:交叉验证、Pipeline、置换重要性、LinearRegression、R²、SGDRegressor、RandomForestClassifier。
2. AdaBoost 的公式约定
课程讲义写出学习器权重 ,并在例子中取 ,配合正确/错误样本的对称指数更新。常见二分类教材使用 配同样的对称更新;这两者在该例子的取值下相符。
因此,必须把系数与样本权重更新式成对阅读。不要把一个版本的系数与另一个版本的更新方式混合,也不要认为任意学习率都会使更新后的错分样本权重和恰好为 0.5。第 12 章保留课程约定,并说明对应条件。
来源:集成学习讲义。这属于公式记号与实现约定的区分,不新增一套独立考试算法。
3. 课程主来源索引
| 内容 | 来源 |
|---|---|
| 考试范围与规定 | Final Exam |
| 课程入口 | BANA409 |
| 01 概览 | Introduction to AI and ML、概览课件 PDF |
| 02 Python | Python Basics、课堂练习、指定 Python 教程 |
| 03 NumPy | NumPy、三维销售数组练习 |
| 04 Pandas | Pandas |
| 05 绘图 | Matplotlib |
| 03–05 共同工具教程 | Data Science Introduction 的 NumPy、Pandas、Matplotlib 与 Pandas Charting 部分 |
| 06 基线 | Kaggle and Model-Free Prediction、Rule-Based Prediction、Heuristic Challenge |
| 07 预处理 | Data Preprocessing |
| 08 树 | Decision Tree Basics、Decision Tree Prediction |
| 09 评估 | Model Evaluation Basics、Evaluation and Selection、Grid Search |
| 09 流水线与解释 | Full Pipeline、Feature Importance、课堂评估练习 |
| 10 回归 | Linear Regression、Interpreting a Linear Regression Model |
| 11 优化 | Gradient Descent |
| 12 集成 | Ensemble Learning |
Python 外链是宽泛参考教程;本资料选择与本课基础学习目标相关的内容,不将整个外部教程等同于考试范围。
4. 作业与复习的对应关系
| 作业 | 应提炼的能力 | 主要章节 |
|---|---|---|
| 作业 1:探索性数据分析 | 业务问题、正确分母、筛选/聚合、图表解释 | 01、03–05 |
| 作业 2:有/无模型的预测 | 规则与模型比较,预处理、预测和提交 | 06–08 |
| 作业 3:评估、流水线与重要性 | 锁定测试集、CV 调参、训练次数、错误成本、模型解释 | 07–09 |
| 作业 4:回归、SGD 与随机森林 | 均值基线、RMSE/MAE/R²、系数和重要性、预测转成收购决策 | 06、09–12;仅模型相关部分 |
作业 4 数据是课程模拟手机数据。其品牌、成色与收益结论只能说明该数据中的关系,不应写成现实手机市场事实。
5. Optional 页面
- Precision, Recall and ROC AUC:精确率/召回率基本公式属于主线;ROC、AUC、阈值变化细节另作拓展。
- Deriving the Normal Equation:主线理解公式和满秩条件;逐步矩阵推导可后看。
- OLS and R-squared:R²在作业中使用,保留核心计算与解释;显著性检验细节标拓展。
这些标签来自课程页面,不构成“不考”的证明。官方明确排除的独立章节见复习导航。
6. 常用术语速查
| 中文(英文) | 中文(英文) | 中文(英文) |
|---|---|---|
| 样本(Instance) | 特征(Feature) | 目标/标签(Target/Label) |
| 监督学习(Supervised learning) | 分类(Classification) | 回归(Regression) |
| 泛化(Generalization) | 过拟合(Overfitting) | 欠拟合(Underfitting) |
| 广播(Broadcasting) | 布尔掩码(Boolean mask) | 分组聚合(Group aggregation) |
| 缺失填补(Imputation) | 标准化(Standardization) | 独热编码(One-hot encoding) |
| 不纯度(Impurity) | 熵(Entropy) | 信息增益(Information gain) |
| 准确率(Accuracy) | 精确率/查准率(Precision) | 召回率/查全率(Recall) |
| 交叉验证(Cross-validation) | 超参数(Hyperparameter) | 数据泄漏(Data leakage) |
| 流水线(Pipeline) | 置换重要性(Permutation importance) | 不纯度重要性(Impurity importance) |
| 损失函数(Loss function) | 梯度(Gradient) | 学习率(Learning rate) |
| 偏差(Bias) | 方差(Variance) | 噪声(Noise) |
| 投票(Voting) | 装袋法(Bagging) | 提升法(Boosting) |
| 自助抽样(Bootstrap sampling) | 袋外评估(Out-of-bag evaluation) | 随机森林(Random forest) |
注意:线性模型的偏置项(Bias term/Intercept)与偏差—方差中的偏差(Bias)不是同一个概念;同一个英文单词要按上下文理解。
网页阅读补充(2026-10-21,v1.2)
在第 02–12 章教学示例中补充 56 组实际运行输出及 5 张代码生成图表,包括门店收入柱状图与交易金额直方图。缺失的中间表格、拟合评估数值及数组结果直接放在对应代码后。自测题与答案的分离方式保持不变。运行环境与示例记录保存在网站仓库 content/course-ml/output-generation.json;输出不用于声称真实业务效果,库版本变化可能影响末位数值。
课程说明、复习范围和来源时点均保留原文表述;自测题为学习练习。
返回博客